GPU 通常成组发射线程指令。同一 warp(NVIDIA)或 wave 内的线程若走不同分支,两条路径可能在不同的活跃线程掩码下执行,从而降低活跃 lane 的比例。分支代价取决于同组数据的分布、各路径的工作量和编译结果。
先看执行单元,再看单条指令的利用率
原笔记用一个逐步改造的例子解释吞吐量。下列示意图用于理解控制逻辑、执行上下文和 ALU 的关系。各厂商真实硬件还有缓存、调度器和专用执行单元,核心数量和 lane 数也因架构而异。
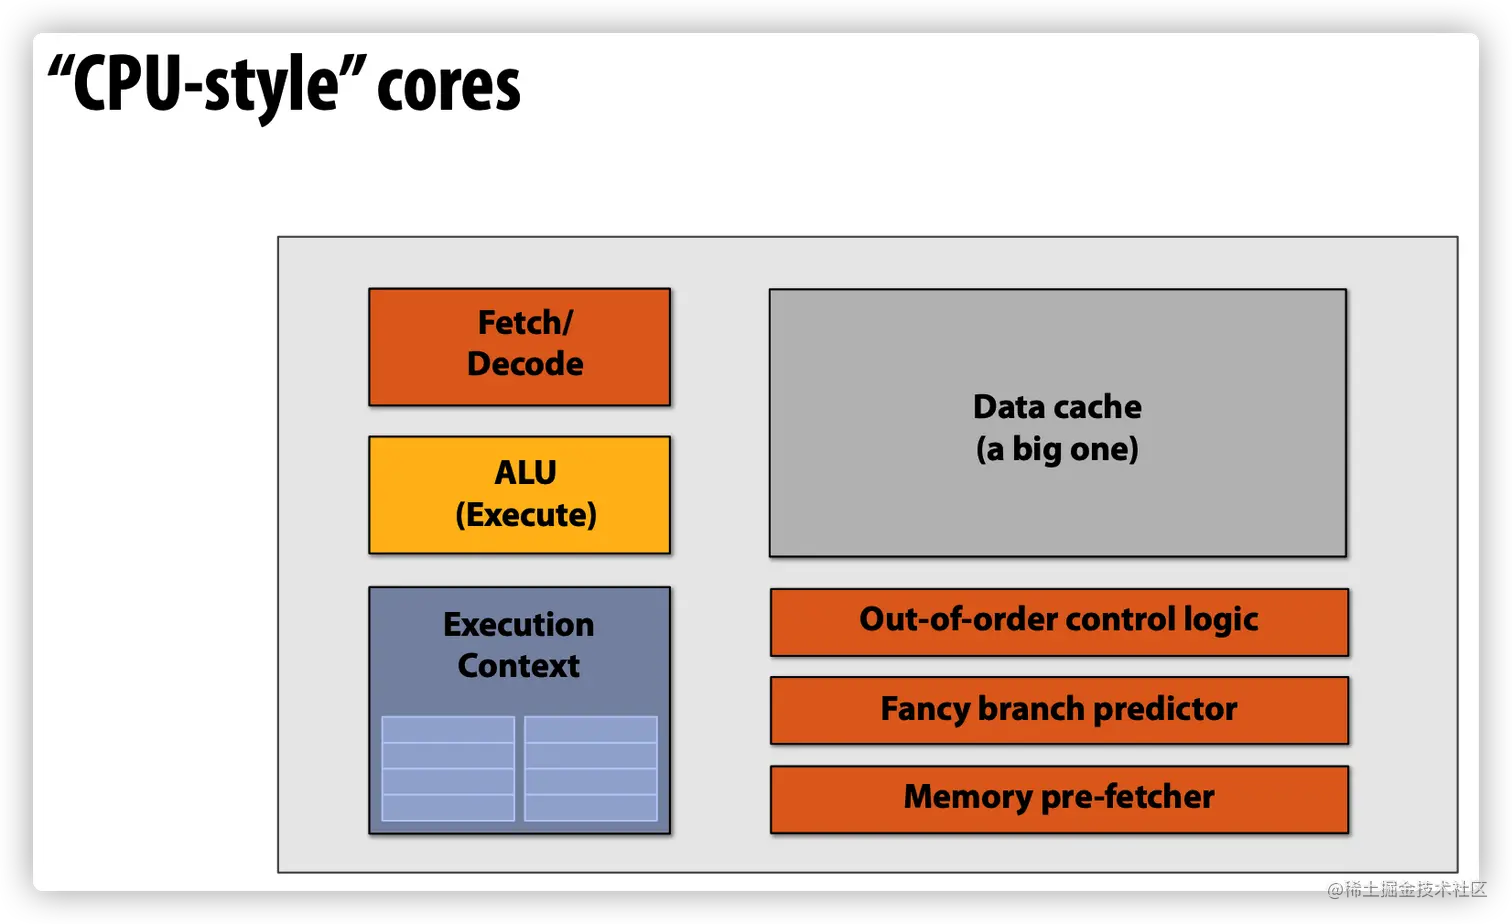
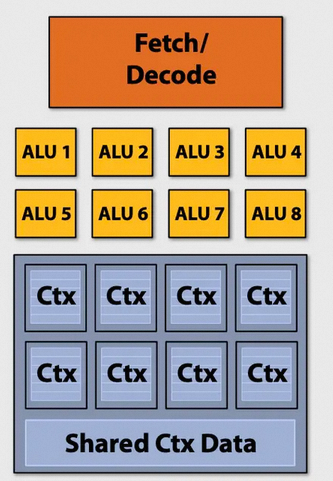
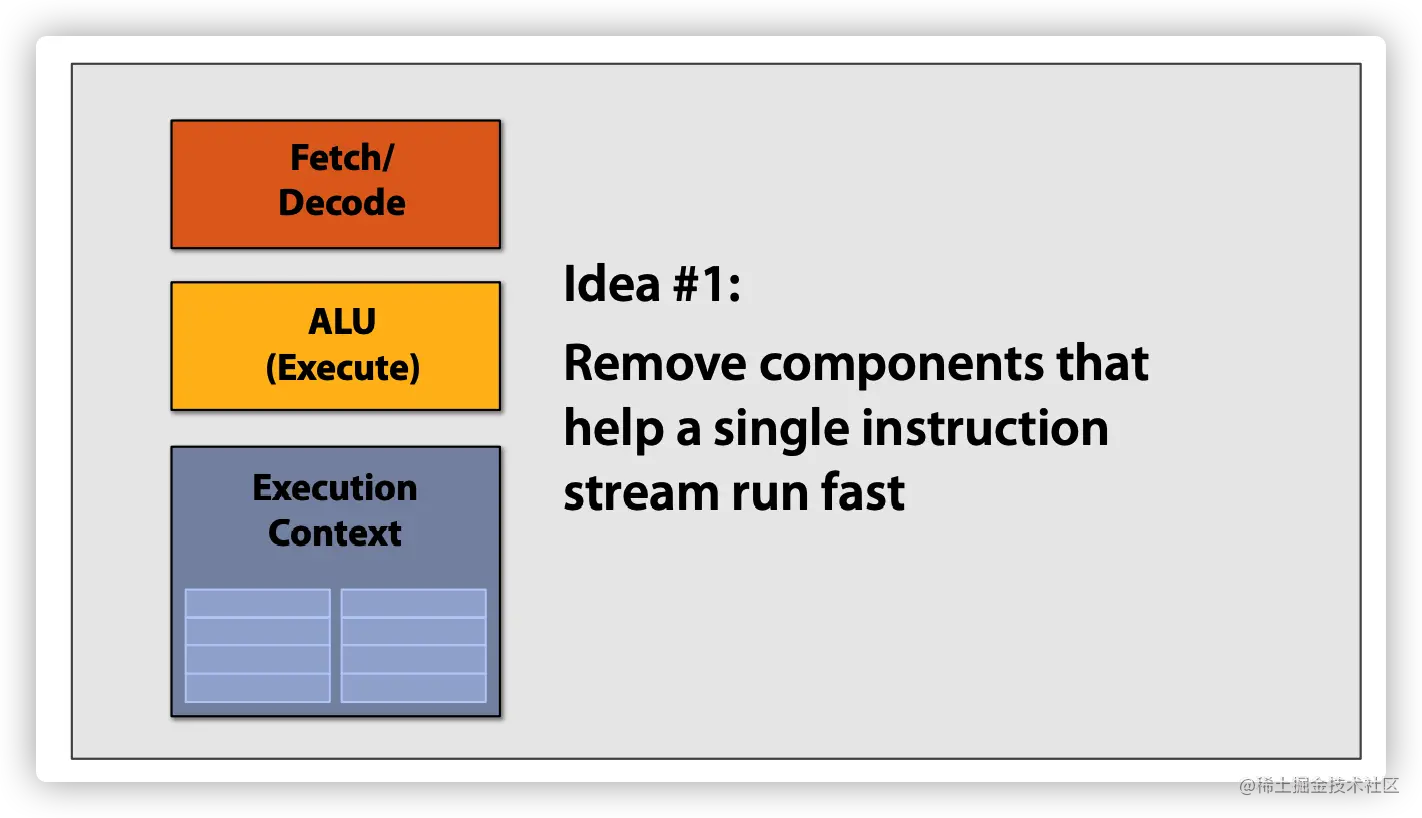
从较重的单核控制逻辑,过渡到更多并行执行单元。重点是芯片预算能支持多少并行工作。
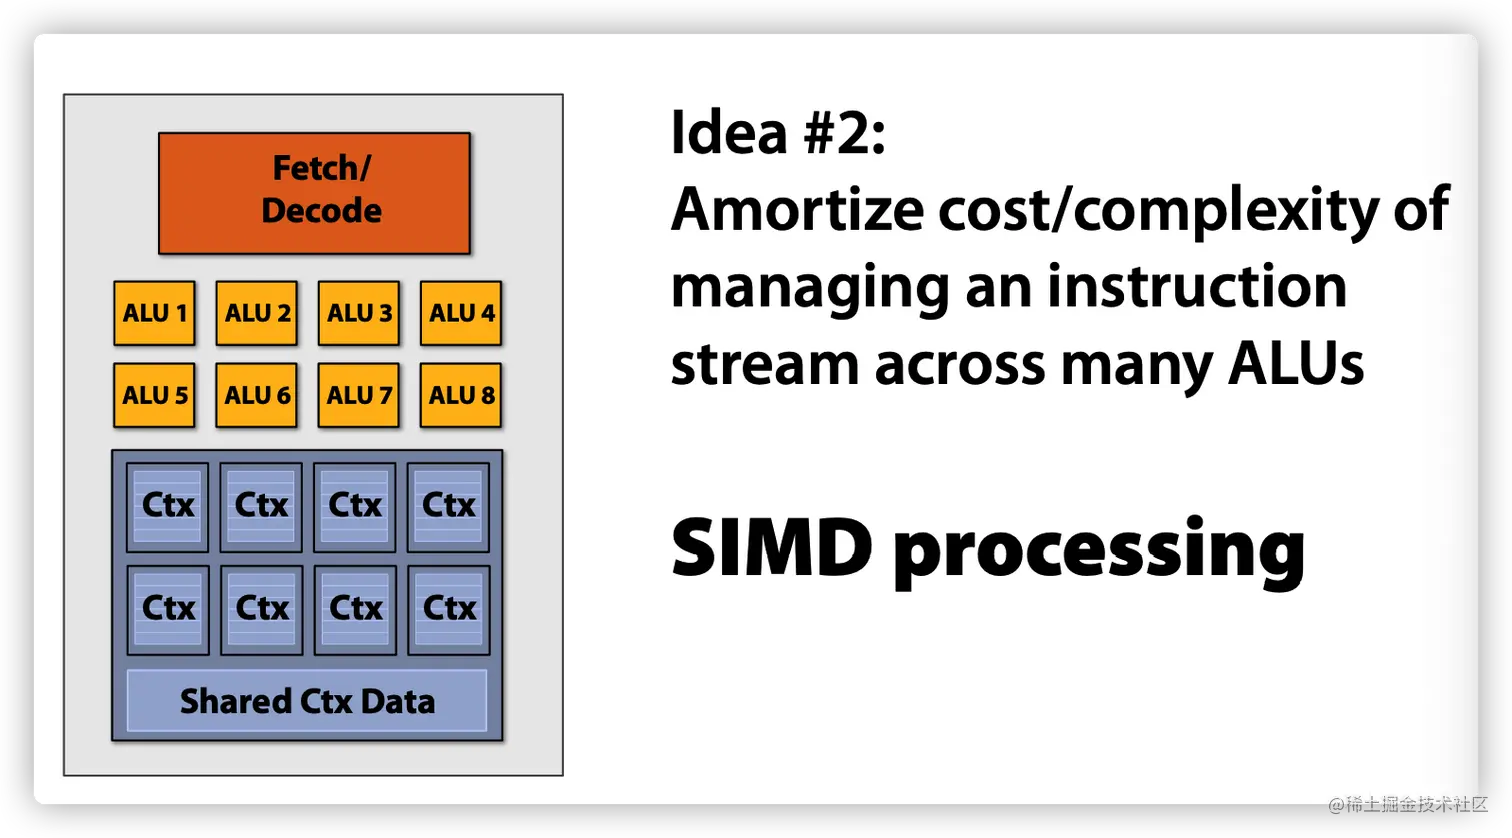
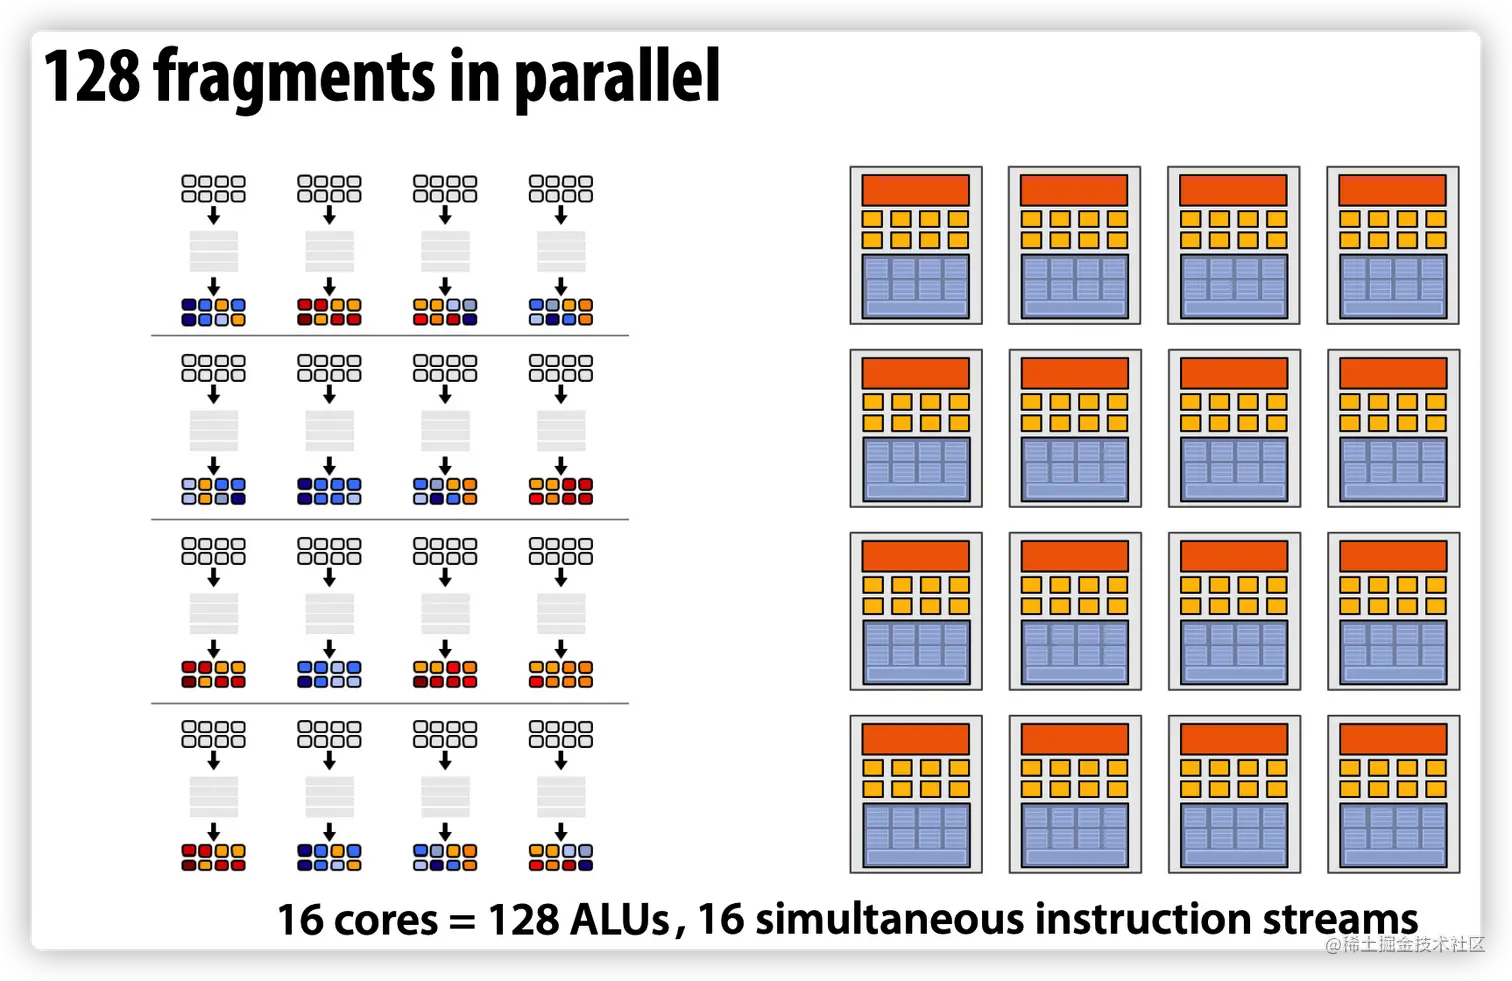
用一份指令控制多条数据通路。原图以 16 组、每组 8 条 lane 作为示意,完全填满时同一轮可覆盖 128 个片元。
SIMD 说的是一条指令处理多份数据。以 NVIDIA 的 SIMT 模型为例,程序员写单线程逻辑,硬件调度一组线程并维护执行掩码。访问下标和分支条件仍按各线程计算。遇到不同路径时,吞吐量要按每条指令的实际活跃 lane 看。
原笔记的分支例子
if (x > 0) {
    y = pow(x, exp);
    y *= Ks;
    refl = y + Ka;
} else {
    x = 0;
    refl = Ka;
}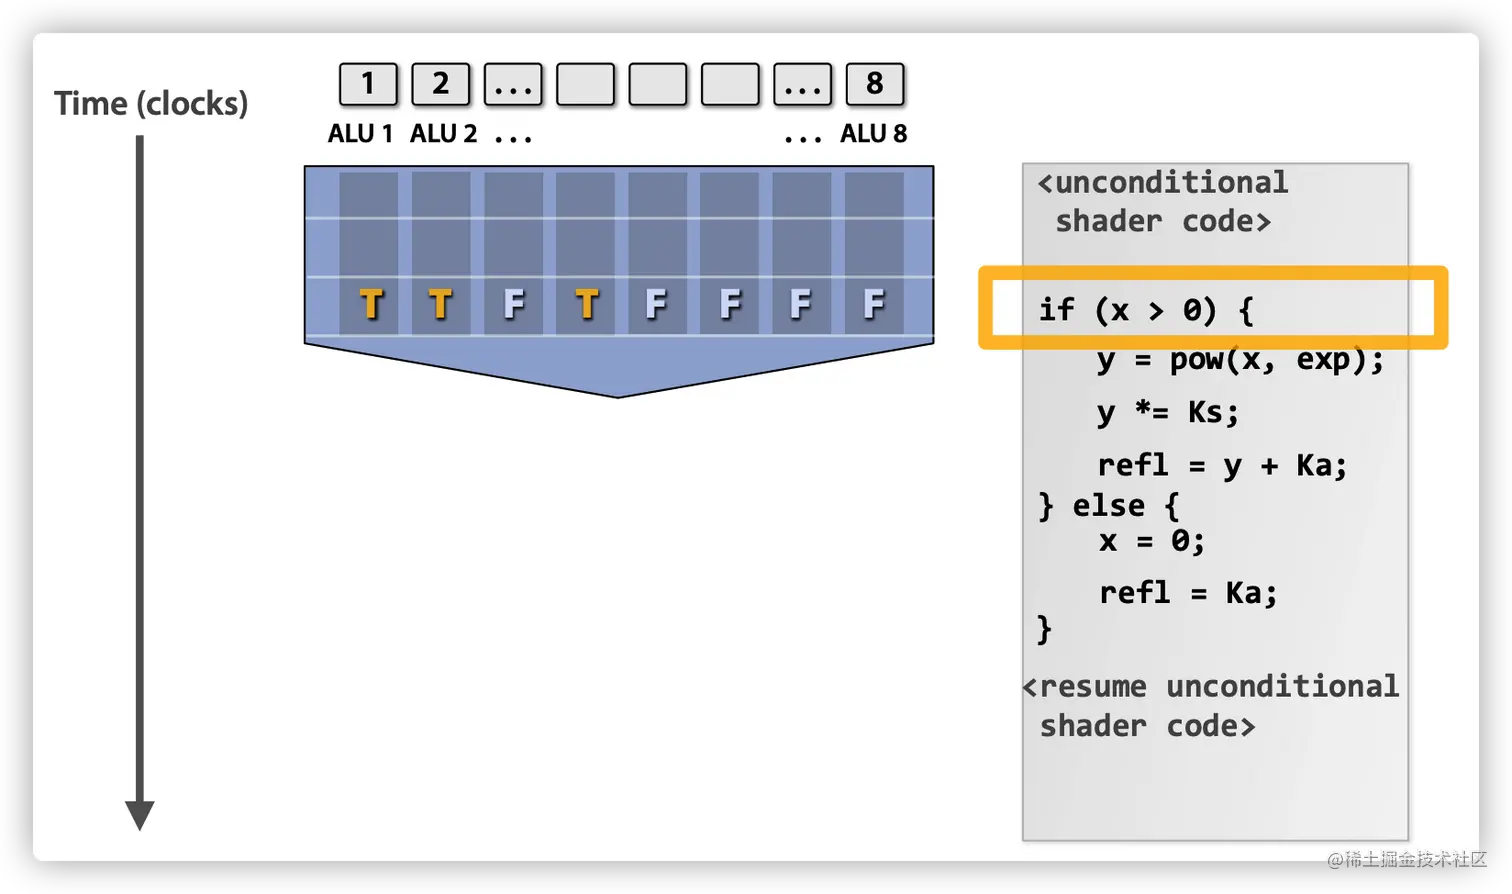
同一个执行组一部分 lane 走 pow 路径,一部分走只使用 Ka 的路径。
如果整组 x 都小于等于零,可以跳过 pow。如果条件混在同组,硬件可能按不同掩码执行两条路径。对于开销差异很大的两支,即使只有一个 lane 要走重路径,整个组仍需为那部分指令排发射时间。编译器也可能针对短分支使用谓词或 select,要看生成的指令。
实际优化可分别对比三种输入。全真给出重路径的基线,全假验证是否确实省掉工作,交错条件展示组内分歧的开销。若按材质或对象聚类后分歧减少,但排序或更分散的访存增加,也要一起计时。宏或预编译变体适合把已知常量分支直接移除。
采样依赖和延迟隐藏
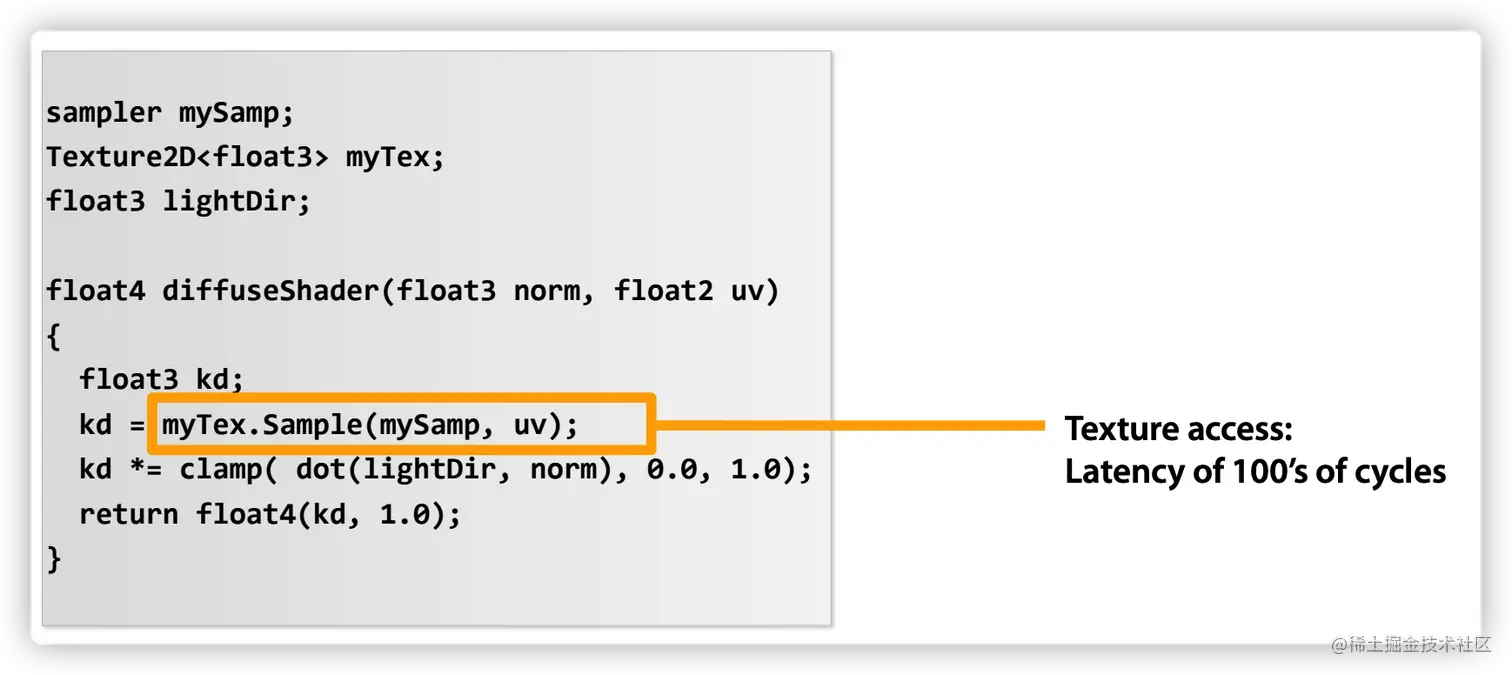
使用纹理采样结果的指令,需要等该采样返回。
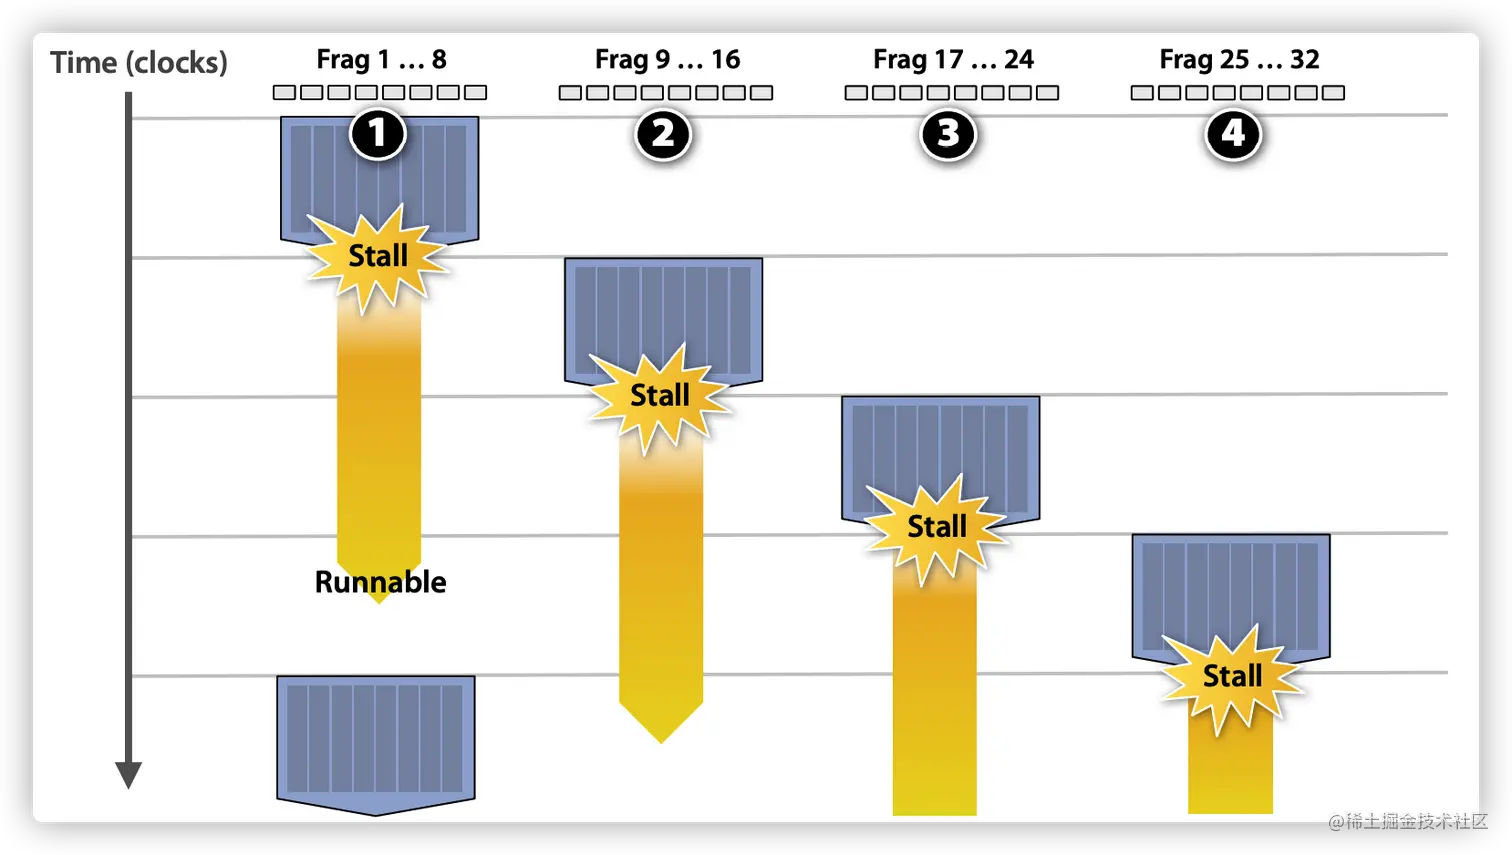
调度器可在一组线程等待操作数时,先发射另一组已经就绪的线程。
只有同一个调度资源上的待运行工作足够多,等待才容易被遮蔽。寄存器和共享内存增多会降低可驻留的线程组数量。若数据太分散,已驻留的执行组也可能同时卡在访存。优化时结合可发射 warp 比例、活跃 lane、cache 命中、访存吞吐和寄存器数。若只是将分支改写成无条件计算,可能多出了采样或寄存器,应该用目标场景校验总 GPU 时间。
相关
- ApexM 渲染优化实战 移动设备上实例合批、剔除和附件带宽的具体案例。
参考
- NVIDIA CUDA Programming Guide · Programming Model
- NVIDIA CUDA C++ Programming Guide · Hardware Implementation