《Apex Legends Mobile》把场景开销压在三个环节。关卡分层和 Level LOD 控制加载,HISM 与 Uniform 实例合批减少提交,CPU 三角形簇剔除在提交前去掉大型网格里被挡住或在视锥外的部分。Render Pass 侧提供 HDR、Lite-HDR、LDR 三档。Lite-HDR 把色调映射和自动曝光放进 Subpass,在支持 Framebuffer Fetch 的设备上省去主颜色缓冲跨 Pass 的读写,同时保留 HDR 半透明混合。
背景
分享来自腾讯光子 Apex 项目引擎组,基于 UE4 Mobile 前向管线。团队要在手游上还原复杂山体、建筑、英雄技能等画面,兼顾主流设备稳定 60 FPS、旗舰设备更高帧率和老设备的基础体验。散热会影响持续帧率,因此带宽和功耗与单帧 GPU 耗时同样重要。项目没有昼夜变化需求,可以大量使用静态光照。
场景光照、关卡与植被
- 按对象选间接光数据。 室内外建筑和山体用 Lightmap,集成 Shadow Mask,并把 Directional SH 拆出供低端档减内存与采样。中小静态物件用 Lighting Probe,在 Primitive 上烘焙球谐系数,复杂模型允许多点烘焙。角色、载具等动态物体用 Indirect Lighting Cache(ILC),项目在 UE4 基础上采用二阶表示和自适应排布。
- 分档处理阴影。 CSM 使用级联距离策略,并缓存静态物体阴影。低画质档的 Shadow Depth 只画动态物体。幻灯片对静态对象分别列出大型物体的 Distance Field Shadow 和小型物体的 Probe,Lightmap 中也有烘焙的 Shadow Mask。
- 把关卡加载和远景表示一起设计。 约
2 × 2 km的端游场景有约1,000–2,000Draw Calls。手游合并材质与模型,按物件类型和尺寸分层,设置不同加载距离,低档屏蔽部分层。分享示例拆出约 500 个 Level,远景大量使用 Level LOD,幻灯片列出的 Draw Call 量级约200–400。这样可减少常驻 Primitive、UObject 和InitViews的负担。子关卡多了以后,再给 World Composition 加分帧处理、预判加载和延迟卸载。 - 压植被的 Overdraw 和采样带宽。 用 Pre-Z 先处理植被覆盖,把深度 Pass 读的 Alpha 与 Base Pass 读的颜色拆成两张贴图。Alpha 可使用 ASTC
8×8,颜色只存 RGB。分享的测试场景中,拆分后带宽约降 20%。Pre-Z 另给 Alpha 采样正向 Mip Bias,0.5在所测场景里能提高缓存命中,代价是植被边缘细节有变化。
两条实例合批路径
静态 HISM。 HISM 通过层级树管理实例的可见性与 LOD。一个 Draw Call 需要连续的实例缓冲区间。视锥剔除把中间的簇丢掉后,前后的可见区间要分开提交。项目把这些可见区间重新拼成连续 Instance Buffer,用可见区间的组合作为 LRU 缓存键。命中时复用缓冲,未命中再组装并入缓存。分享的跑分场景中 Miss 低于 5%,即 95% 以上的组装请求可复用。低端档还可调 LOD Distance Scale,让实例更早切到低 LOD。
动态 Uniform 合批。 UE4 GPU Scene 需要 Compute Shader 更新 Primitive 数据,并维护 PrimitiveID Buffer。所述 Android 路径还会让顶点着色器读纹理缓冲,部分高通设备上观察到渲染模式从 Binning 切至 Direct。Apex 由 CPU 把每帧可合批对象的 Primitive 数据打包成 Uniform 数组,顶点着色器直接用 InstanceID 索引。每批上限受 Uniform 容量和设备兼容性制约,团队在部分低端设备上观察到超过 2 KB 就有兼容问题。分享给出的低端跑分场景帧时从 GPU Scene 路径约 28 ms 降到 22 ms。
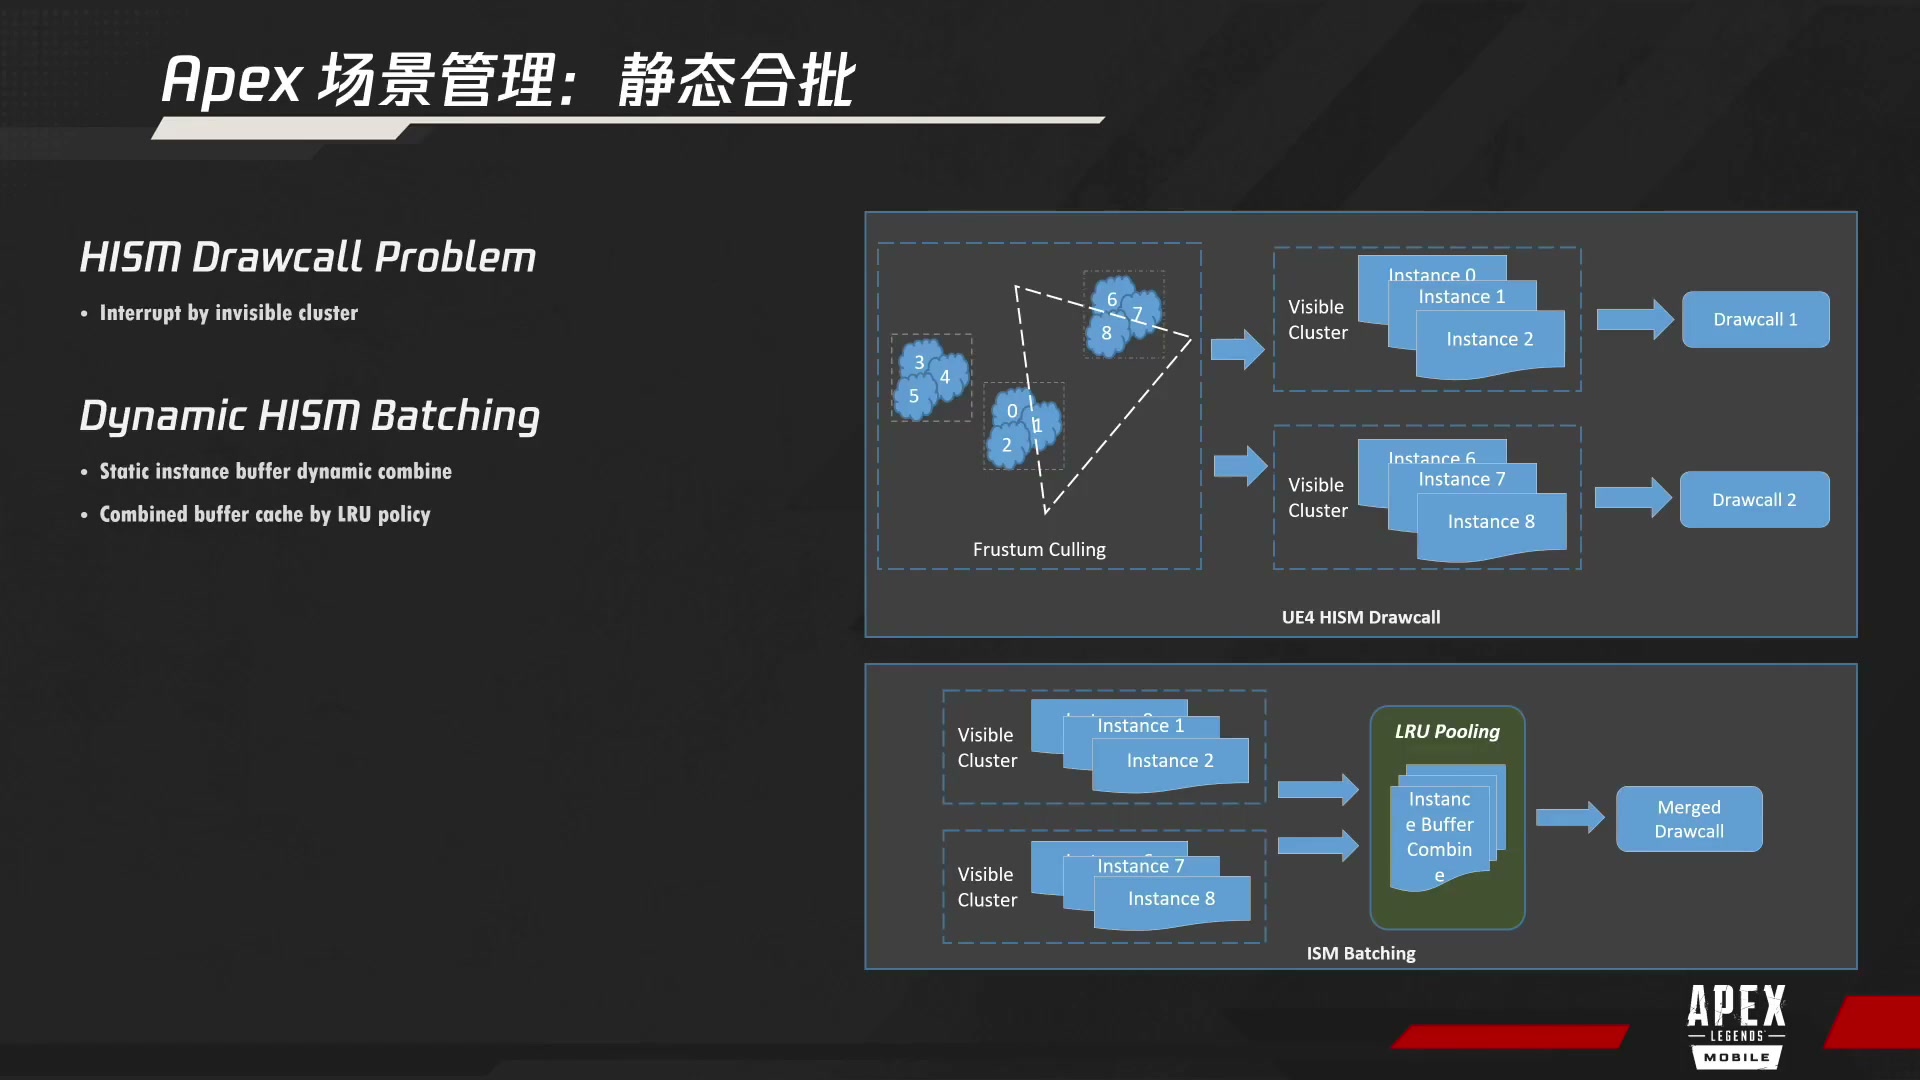
原片 10:50。两段可见 Instance Buffer 中间有空洞,直接提交要分成两次 Draw Call。下半图展示合并与 LRU 复用。
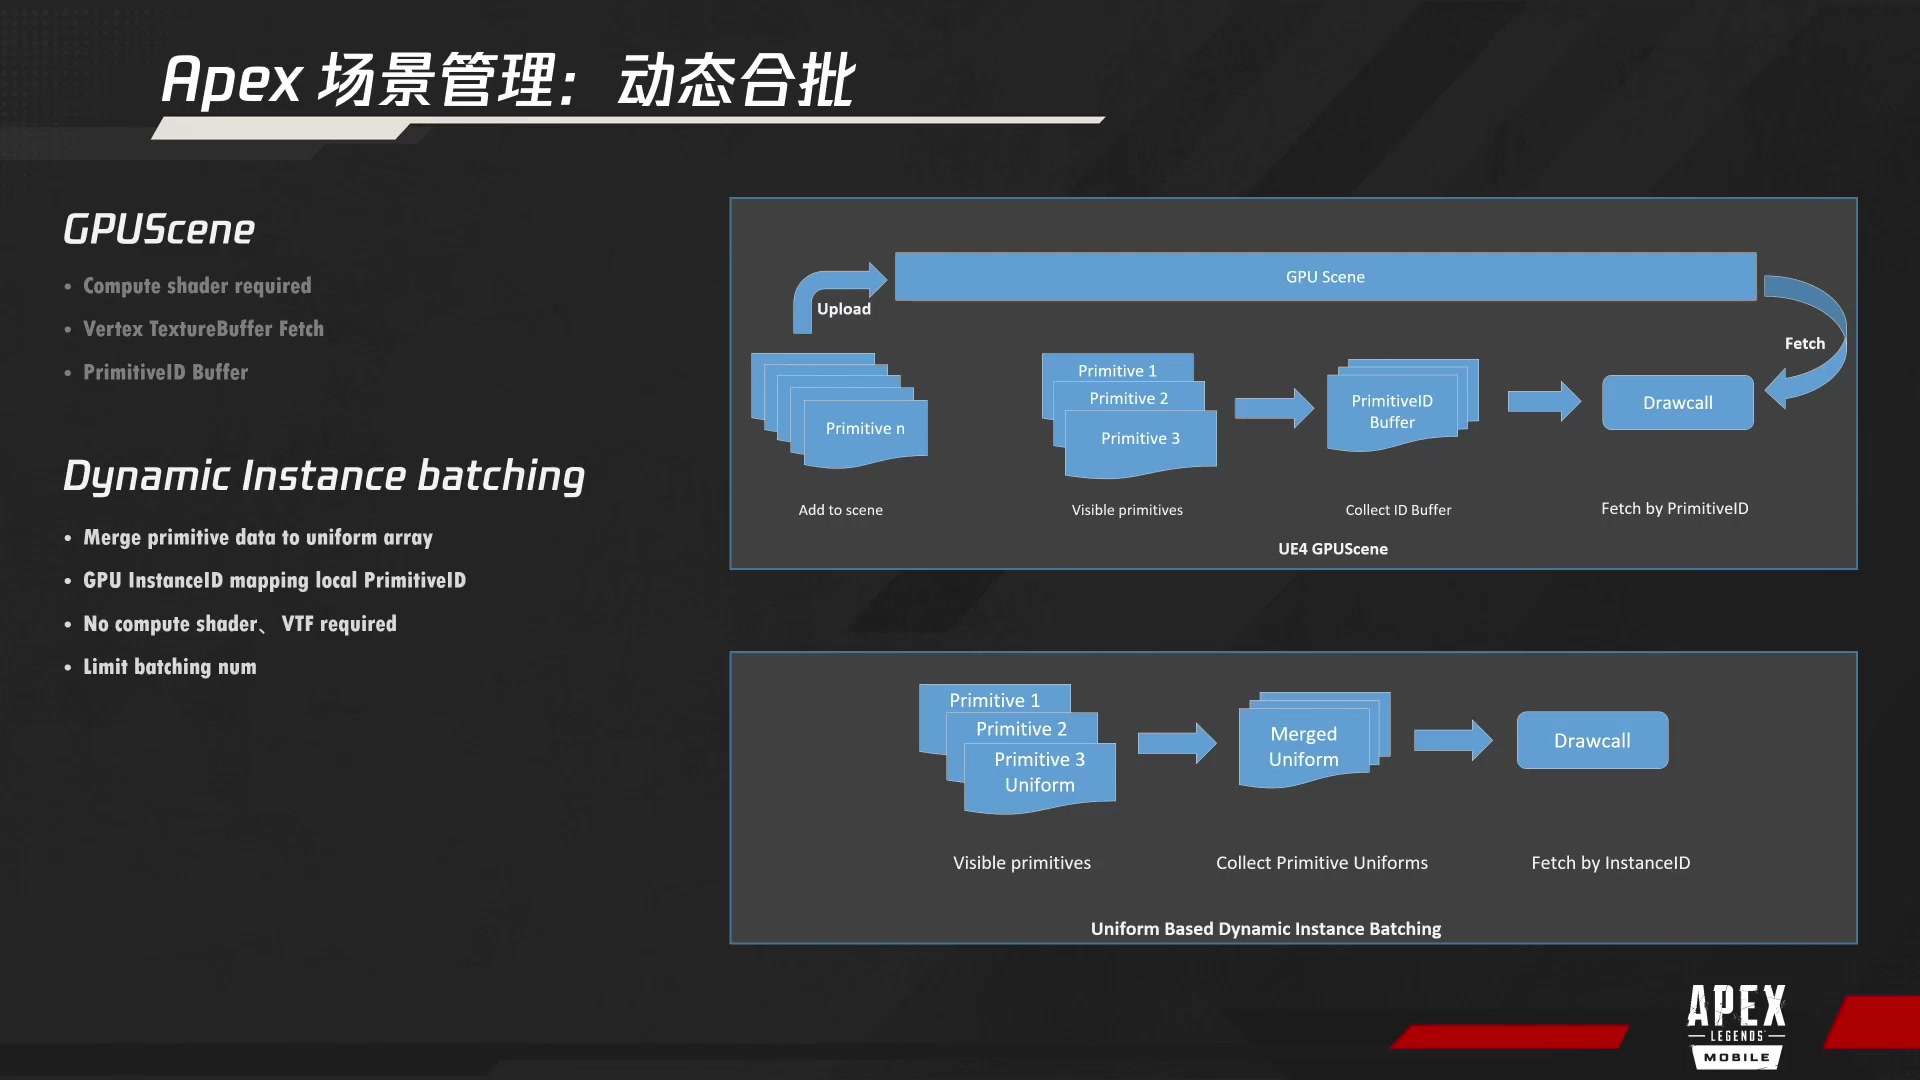
原片 13:16。下半图把每个批次的局部 Primitive 数据打包进 Uniform,顶点着色器按 InstanceID 取值。
大型网格的 CPU 三角形簇剔除
常规流程已有 SIMD 软件光栅遮挡、预处理遮挡体、屏占比剔除和网格分区视锥剔除。巨型山体与地标的整体包围盒仍太大。窄缝即使只露出物体很小一块,整个网格也可能被提交,GPU 顶点阶段照样处理大量无像素贡献的三角形。团队评估过 GPU Driven 和拆 Mesh 后重组 HLOD。前者涉及低端设备的 Compute 支持和 UE 管线改造,后者增加对象、内存和美术制作成本。
- DDC 生成期建树。 按空间位置把三角形划成二叉层级簇,父簇包围子簇。重排已有 Index Buffer,让每个簇的索引都落在一个连续区间。运行时只需保留包围盒、索引区间等元数据,即可按区间提交,不必给每个簇造独立 Mesh。
- 在
InitViews后执行。 常规对象剔除完成后,在MeshPassSetup线程沿用MeshDrawCommand流程。深度优先遍历簇树,做视锥测试和软件遮挡缓冲查询,记录可见索引区间,再进入排序、合批和提交。 - 利用层级和帧间局部性。 父簇已不可见时跳过整棵子树。父簇完全在视锥内时,后代可省去视锥测试。近期可见的簇可跨帧复用可见性,少剔除一部分几何,换取更低的 CPU 遍历开销。项目在各档设备默认启用这条路径,簇粒度可分档配置,幻灯片列出的范围为
32–256。
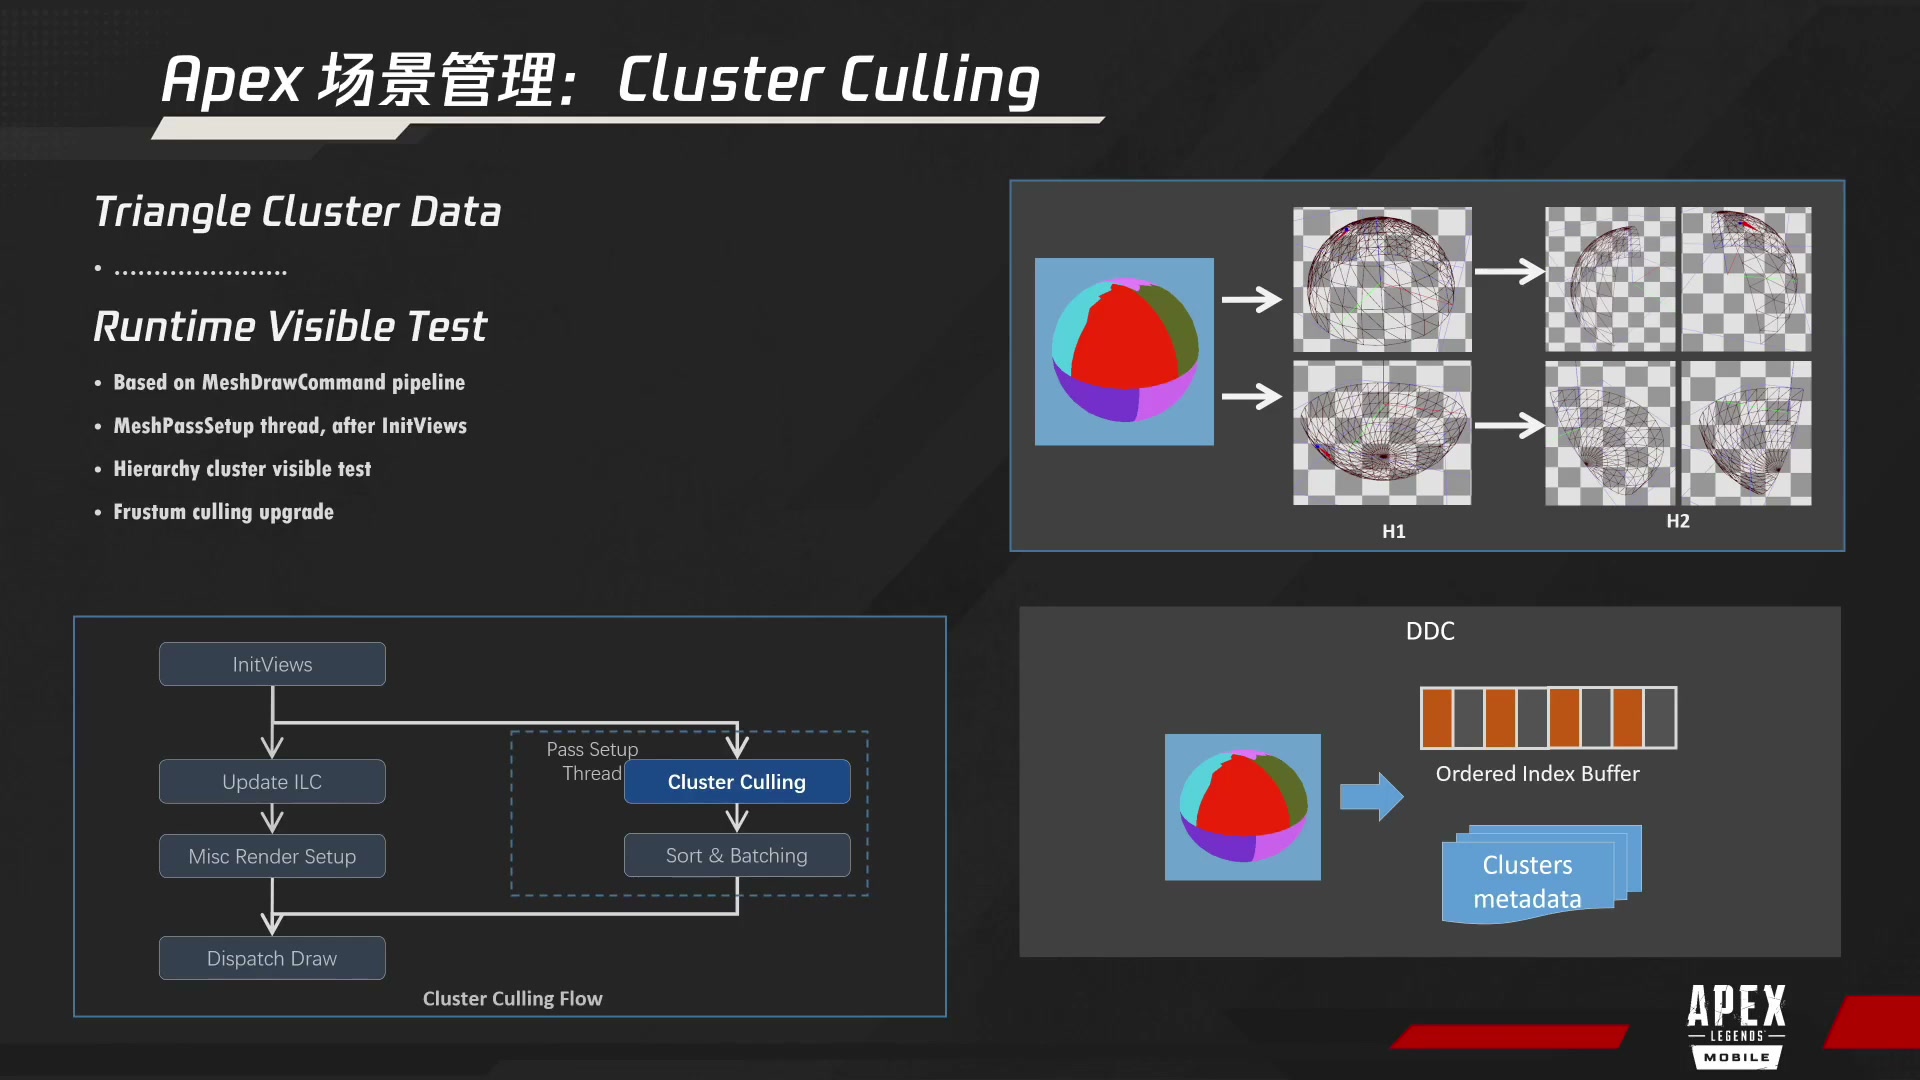
原片 19:36。簇数据引用重排后的索引区间,运行时在 InitViews 后、排序和合批前处理。
簇遍历与索引区间
以半开区间 [firstIndex, endIndex) 表达每个簇。剔除掉父簇就无需访问它的子树。父簇完全在视锥内时,可以向下传递这个结论。下面的 C++ 风格伪代码展示这两条提前退出路径,ranges 后续可合并相邻区间。遮挡测试要保守,只有确认整个包围盒被遮住才跳过。
void CollectVisible(const Cluster& cluster, bool insideFrustum, Ranges& ranges)
{
    if (!insideFrustum) {
        auto relation = ClassifyFrustum(cluster.bounds);
        if (relation == Outside)
            return;
        insideFrustum = (relation == Inside);
    }

    if (SoftwareOccluder.FullyOccludes(cluster.bounds))
        return;

    if (cluster.IsLeaf()) {
        ranges.Add(cluster.firstIndex, cluster.endIndex);
        return;
    }

    CollectVisible(*cluster.left,  insideFrustum, ranges);
    CollectVisible(*cluster.right, insideFrustum, ranges);
}
例如四个叶簇分别占索引区间 [0, 96)、[96, 192)、[192, 288)、[288, 384),第二簇被剔除后,第三和第四簇可按同一个 [192, 384) 提交。这里每个叶簇原有 32 个三角形,最后从 128 个降到 96 个,剩两个连续索引区间。剔除粒度越细,越容易出现这种索引空洞,因此应同时看三角形数、可见区间数和 Draw Call。
分享汇总约可剔除 15–60% 的三角形,Draw Call 约减少 0–15%。21:44 的表里,飞行视角剔除三角形 15.71–40.77%,其中一处 Draw Call 反增约 0.99%。街巷两例为 50.89% 和 57.60%,室内最高一例 61.78%。表内该阶段耗时为 0.21–0.49 ms,讲者指出它在多线程上执行。元数据与缓存的额外内存约 2–8 MB,幻灯片把 DrawCommandPassSetup 开销标为 InitViews 的约 5–20%。
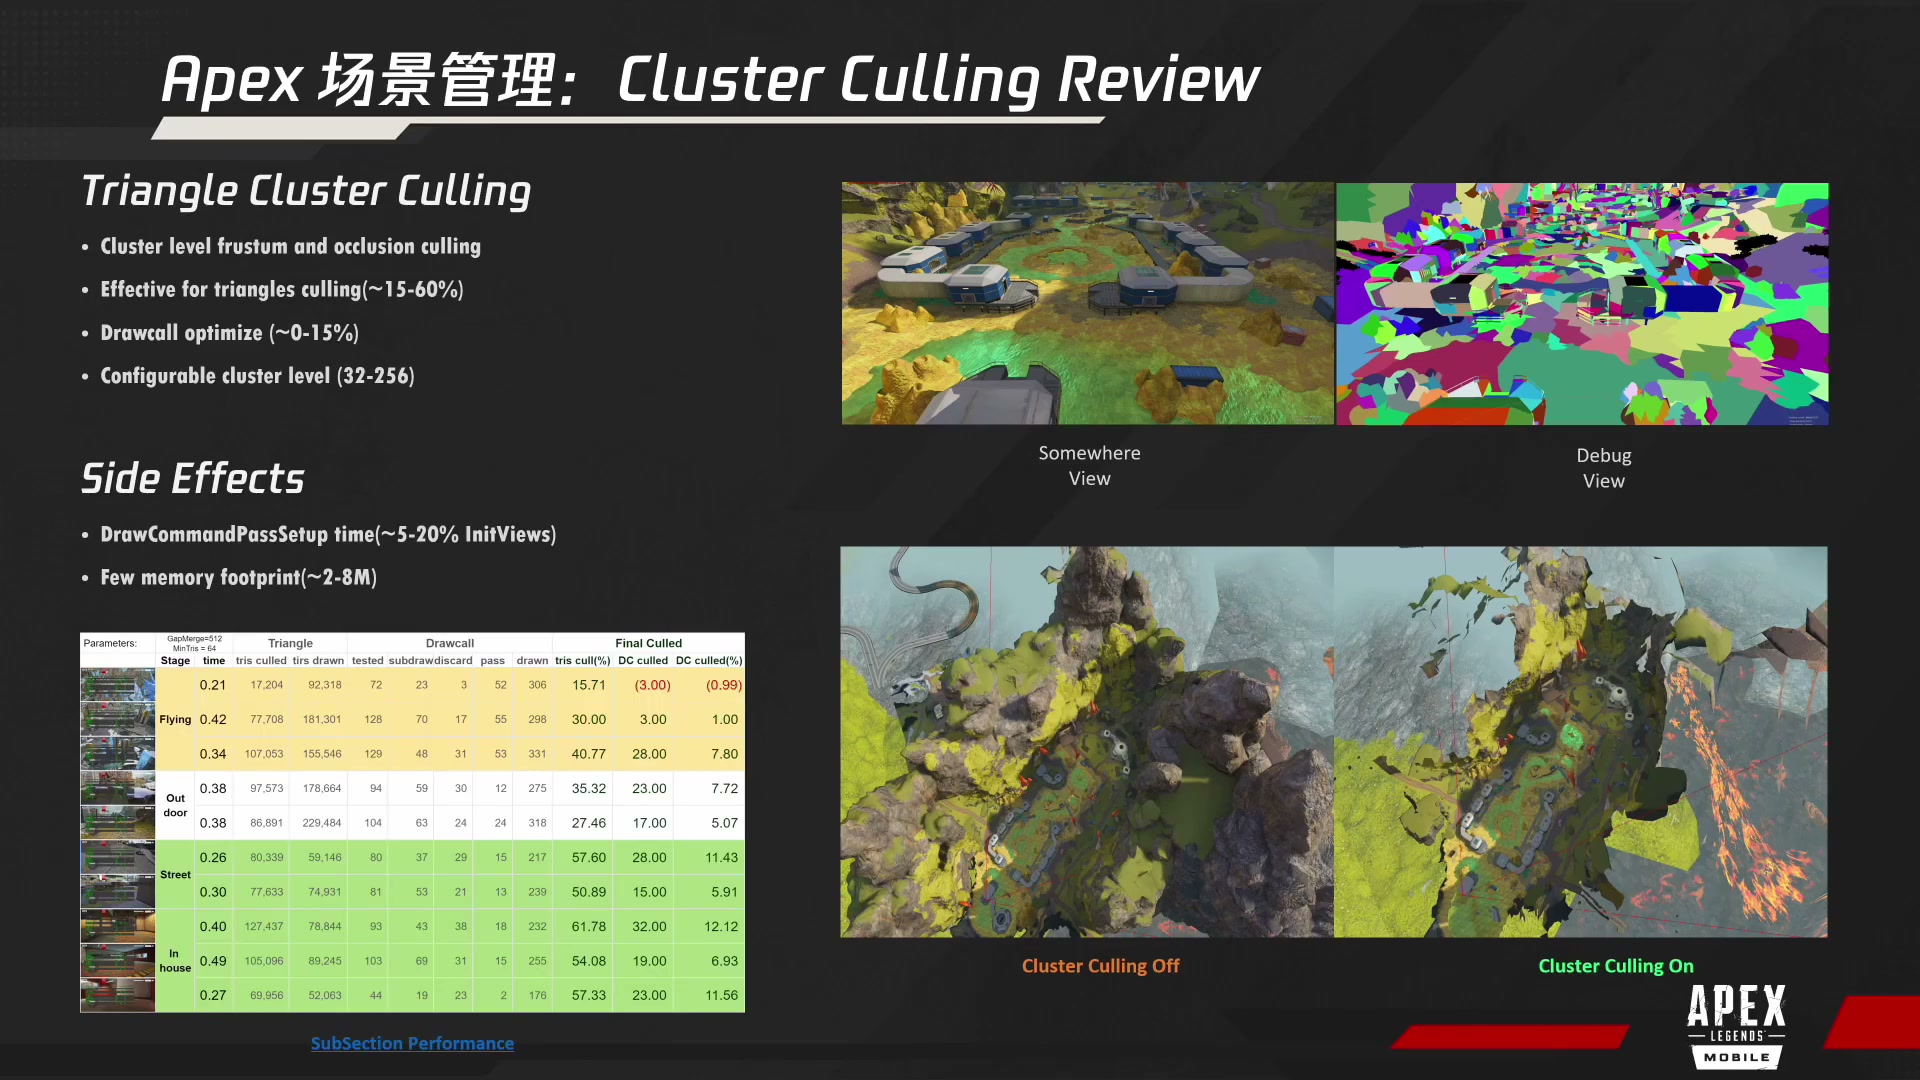
原片 21:44。左下表保留了一个 Draw Call 略增的飞行样本,右下图展示同一视角开启前后的实际提交几何。
HDR 与 LDR 的改造
| 路径 | UE4 Mobile 基线 | Apex 改动 |
|---|---|---|
| HDR | 在 HDR Base Pass 画不透明与半透明,之后经 Bloom、自动曝光、CombineLUT 和 Tonemapper 输出到 LDR Backbuffer,再画 UI | Bloom 分帧,讲者称少了两个 Pass。色调映射改成拟合曲线。自动曝光用 Pixel Shader,并跨帧更新 |
| LDR | 直接渲染到 Backbuffer,在 Base Pass 做 Gamma 校正 | 将足够轻量的拟合 Tonemapper 放进 Base Pass,引入通过 ILC 估计的预曝光。此档的半透明混合空间仍与 HDR 档有差别 |
- 拟合 Tonemapper。 保留 Filmic 的
Slope、Toe、Shoulder、Black Clip、White Clip等美术输入,预先拟合到 ACES 形式的有理函数。运行时执行少量 ALU 指令,省掉生成CombineLUT的 Pass,也避开以颜色作为 LUT 坐标时跳读带来的缓存问题。 - 分阶段更新自动曝光。 第一步从 Base Pass 颜色或复用的 Bloom 降采样结果累积屏幕亮度。第二步归约到
1×1的 RG 纹理,存当前适应亮度和期望目标,以便下一次更新做时间过渡。用跨帧缓存错开两步后,每帧只需增加一个曝光 Pass。
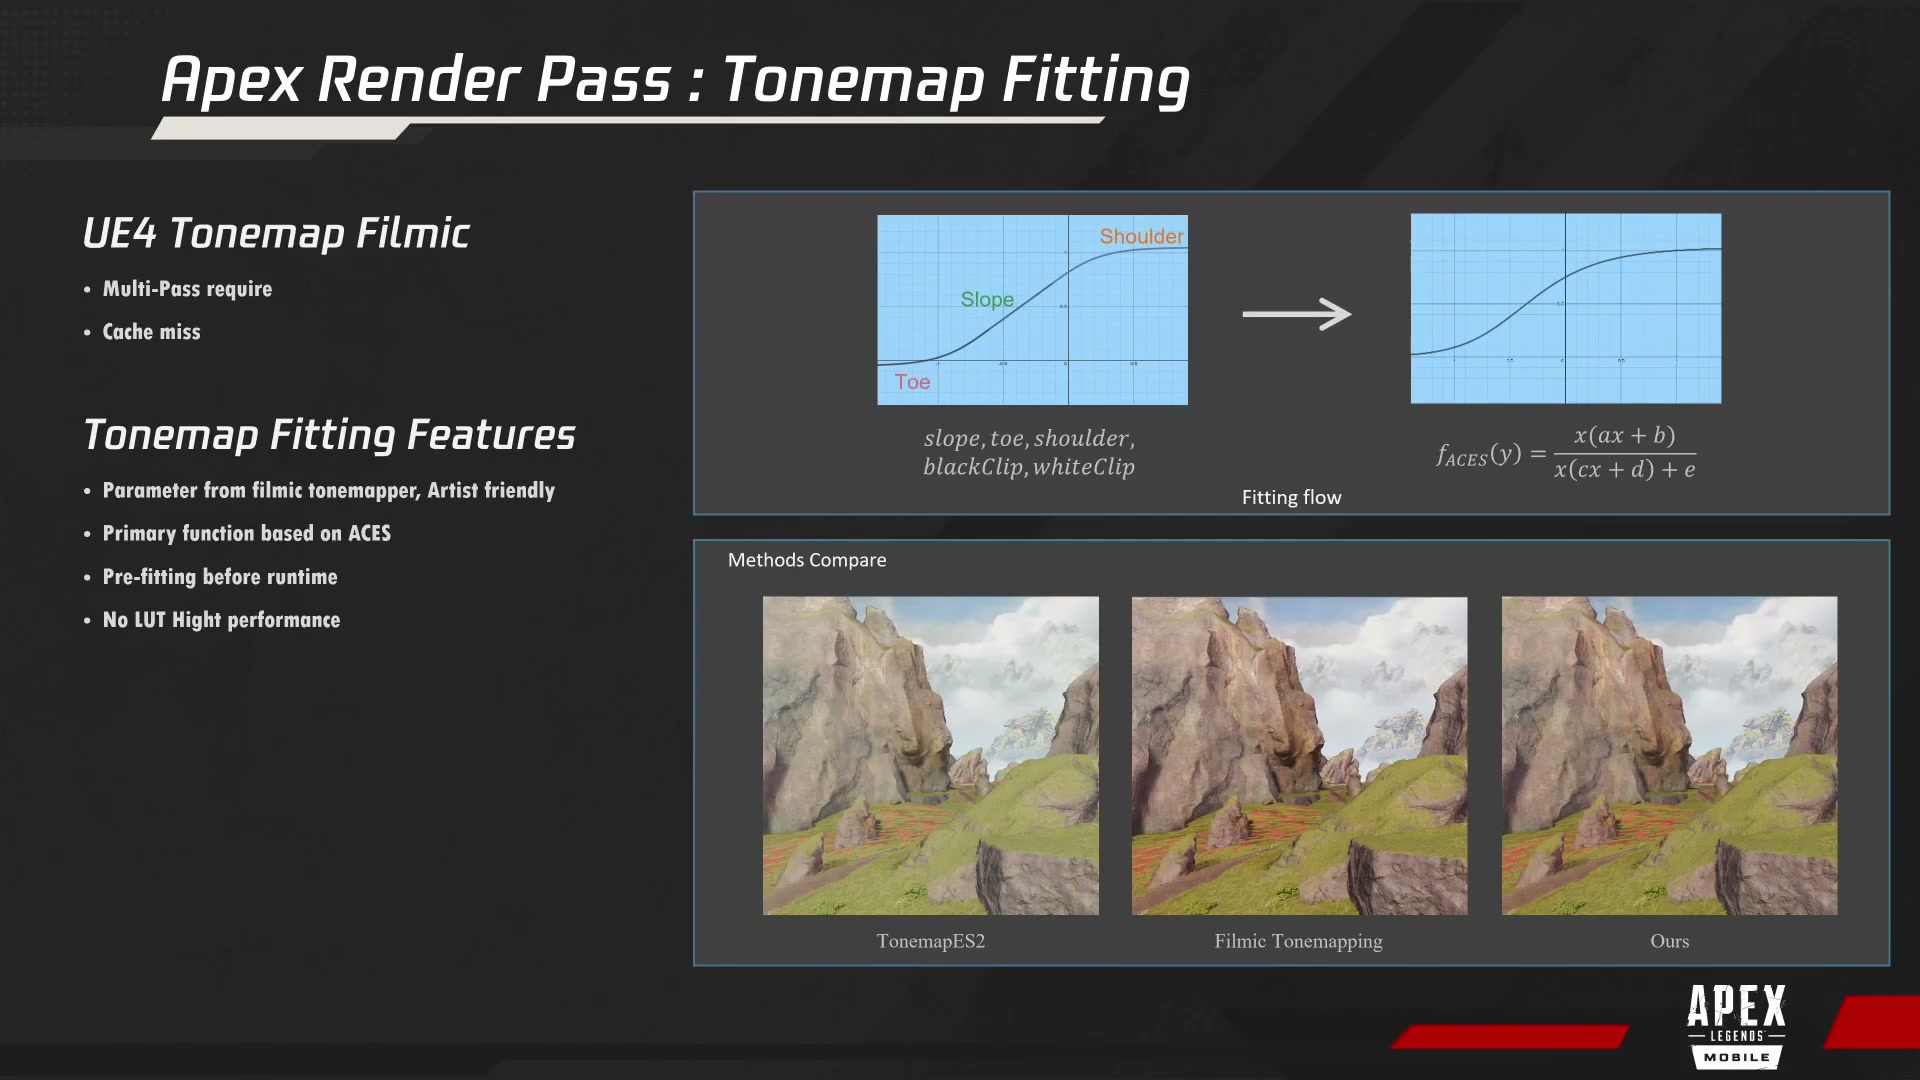
原片 26:20。用 Filmic 美术参数拟合有理函数,并展示 ES2、Filmic 和项目拟合结果。
报告给出的函数族为
是曲线输入, 至 是拟合后供运行时读取的系数。下面只示意曲线求值。曝光、色域转换以及最终输出编码由所在管线决定。
float3 EvalFittedCurve(float3 x, float a, float b, float c, float d, float e)
{
    float3 numerator = x * (a * x + b);
    float3 denominator = x * (c * x + d) + e;
    return numerator / denominator;
}
Lite-HDR 把后处理留在 Subpass
移动端的 Tile-Based Rendering(TBR)对主颜色附件跨 Pass 的 Load/Store 敏感。Lite-HDR 从不透明、半透明到后处理与 Slate UI 都组织在同一主 Render Pass 的 Backbuffer 路径中,尽量把中间颜色留在 Tile 内。
- 暂存 HDR 颜色。 Backbuffer 格式本身容纳不了浮点 HDR 颜色。分享列出 Memoryless MRT、Mali Pixel Local Storage 或
HDR 32 Bpp编码等实现选项。后处理 Subpass 通过 Framebuffer Fetch 读取并解码颜色,在 Tile 内执行拟合 Tonemapper。 - 在 Subpass 做曝光归约。 第一步画一批稀疏屏幕采样点,Fetch 颜色后用
imageStore把亮度写进小纹理。第二步画很小的 Quad,读取上一阶段的亮度纹理并归约,仍用imageStore写曝光结果。 - 按设备能力选档。 Lite-HDR 依赖 Framebuffer Fetch,分享时的实现暂缺 Bloom 和抗锯齿。能承担多 Pass 且需要完整后处理的档位仍可使用 HDR,老设备可用增强后的 LDR。
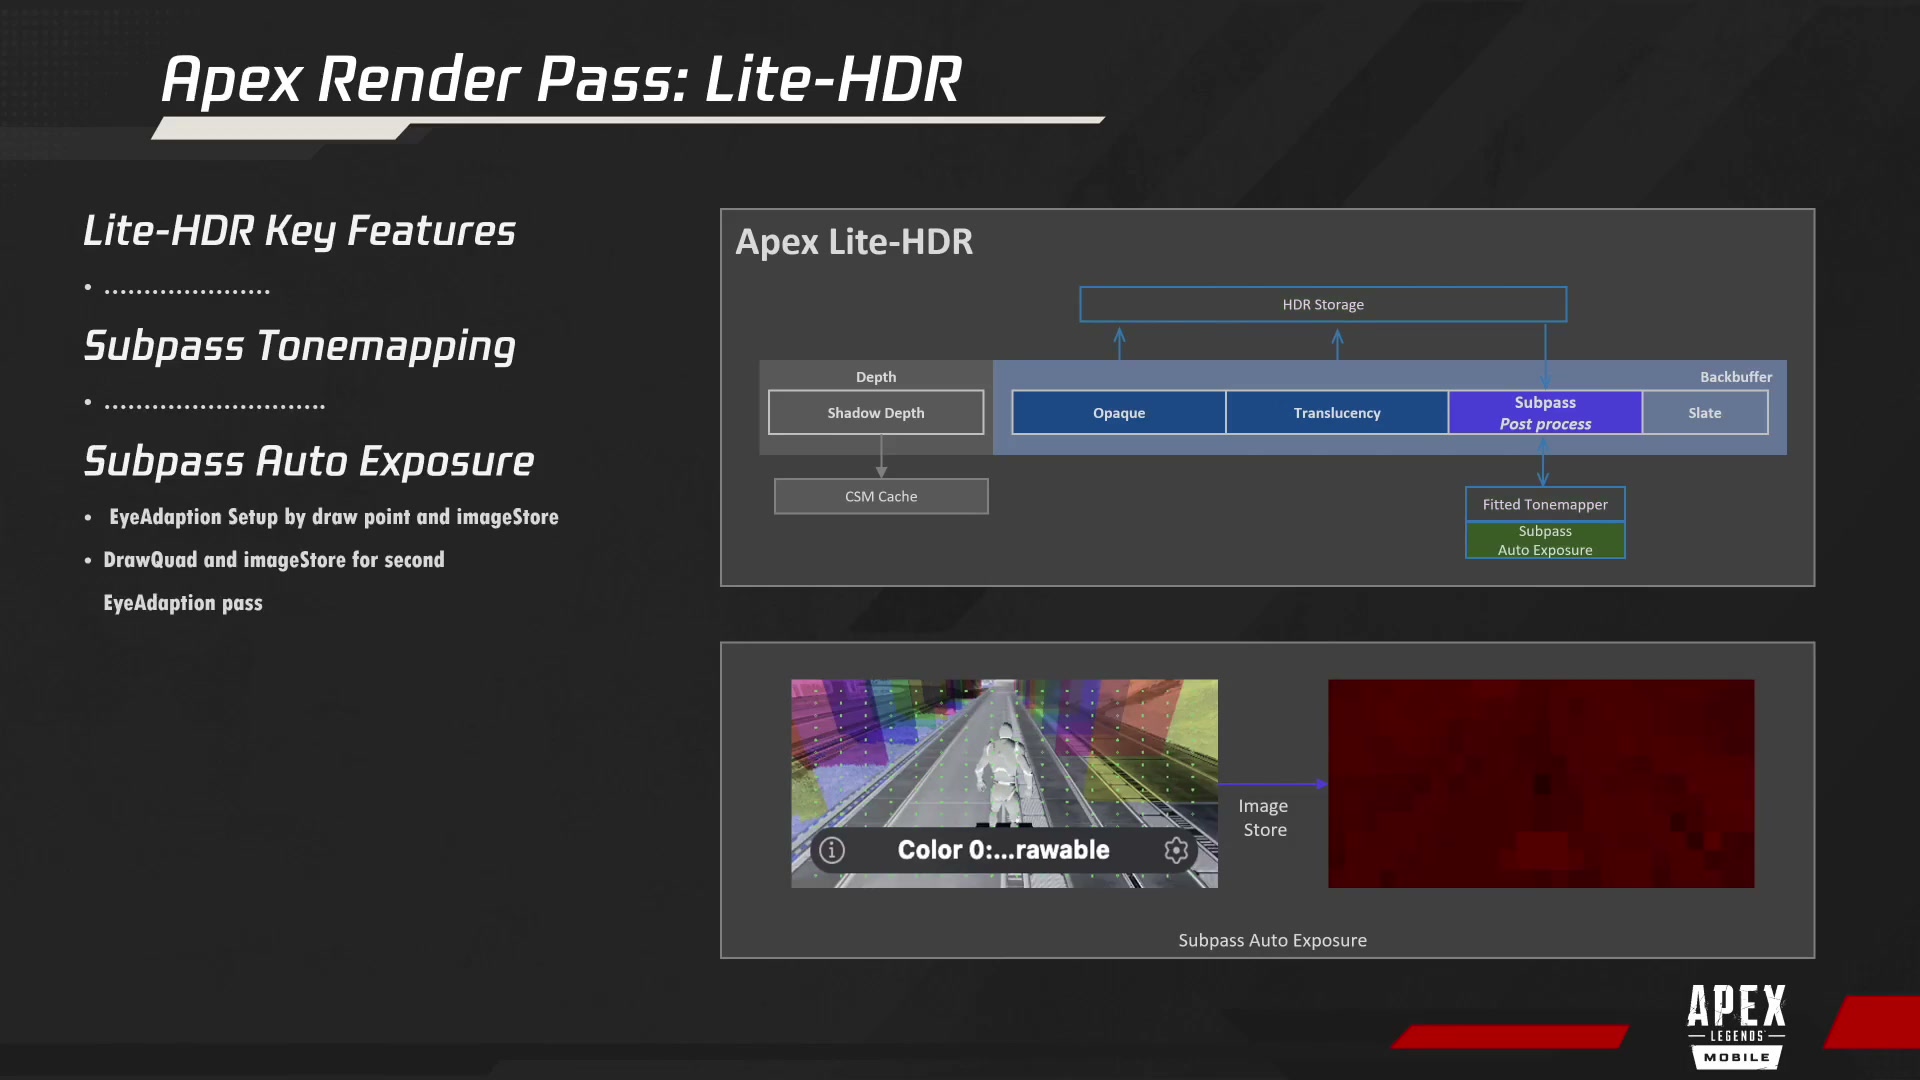
原片 31:12。主颜色流程在一个 Render Pass 内,稀疏取样仍通过 imageStore 形成用于第二步归约的亮度数据。
一次附件往返的带宽量级
对宽高 、每像素 字节、每秒 帧的颜色附件,用一次整张 Store 加一次整张 Load 估算理论流量。
例如 1280 × 720、RGBA16F(8 B/像素)、60 FPS,对应约 0.885 GB/s 的未压缩有效载荷。这个算例只估算一张附件的完整往返,实测外存字节还取决于压缩、Tile、缓存、访问覆盖和剩余 Pass。
分享归纳的 Lite-HDR 收益范围是 GPU 耗时约降 0–25%、GPU 带宽约降 10–30%。31:46 的 iPhone 13 Pro Max 最小测试场景里,GPU 耗时、读字节、写字节分别下降 10.74%、25.20%、24.16%,最后级缓存读写分别下降 15.71%、23.77%。这些数值对应幻灯片所列基线和设备。
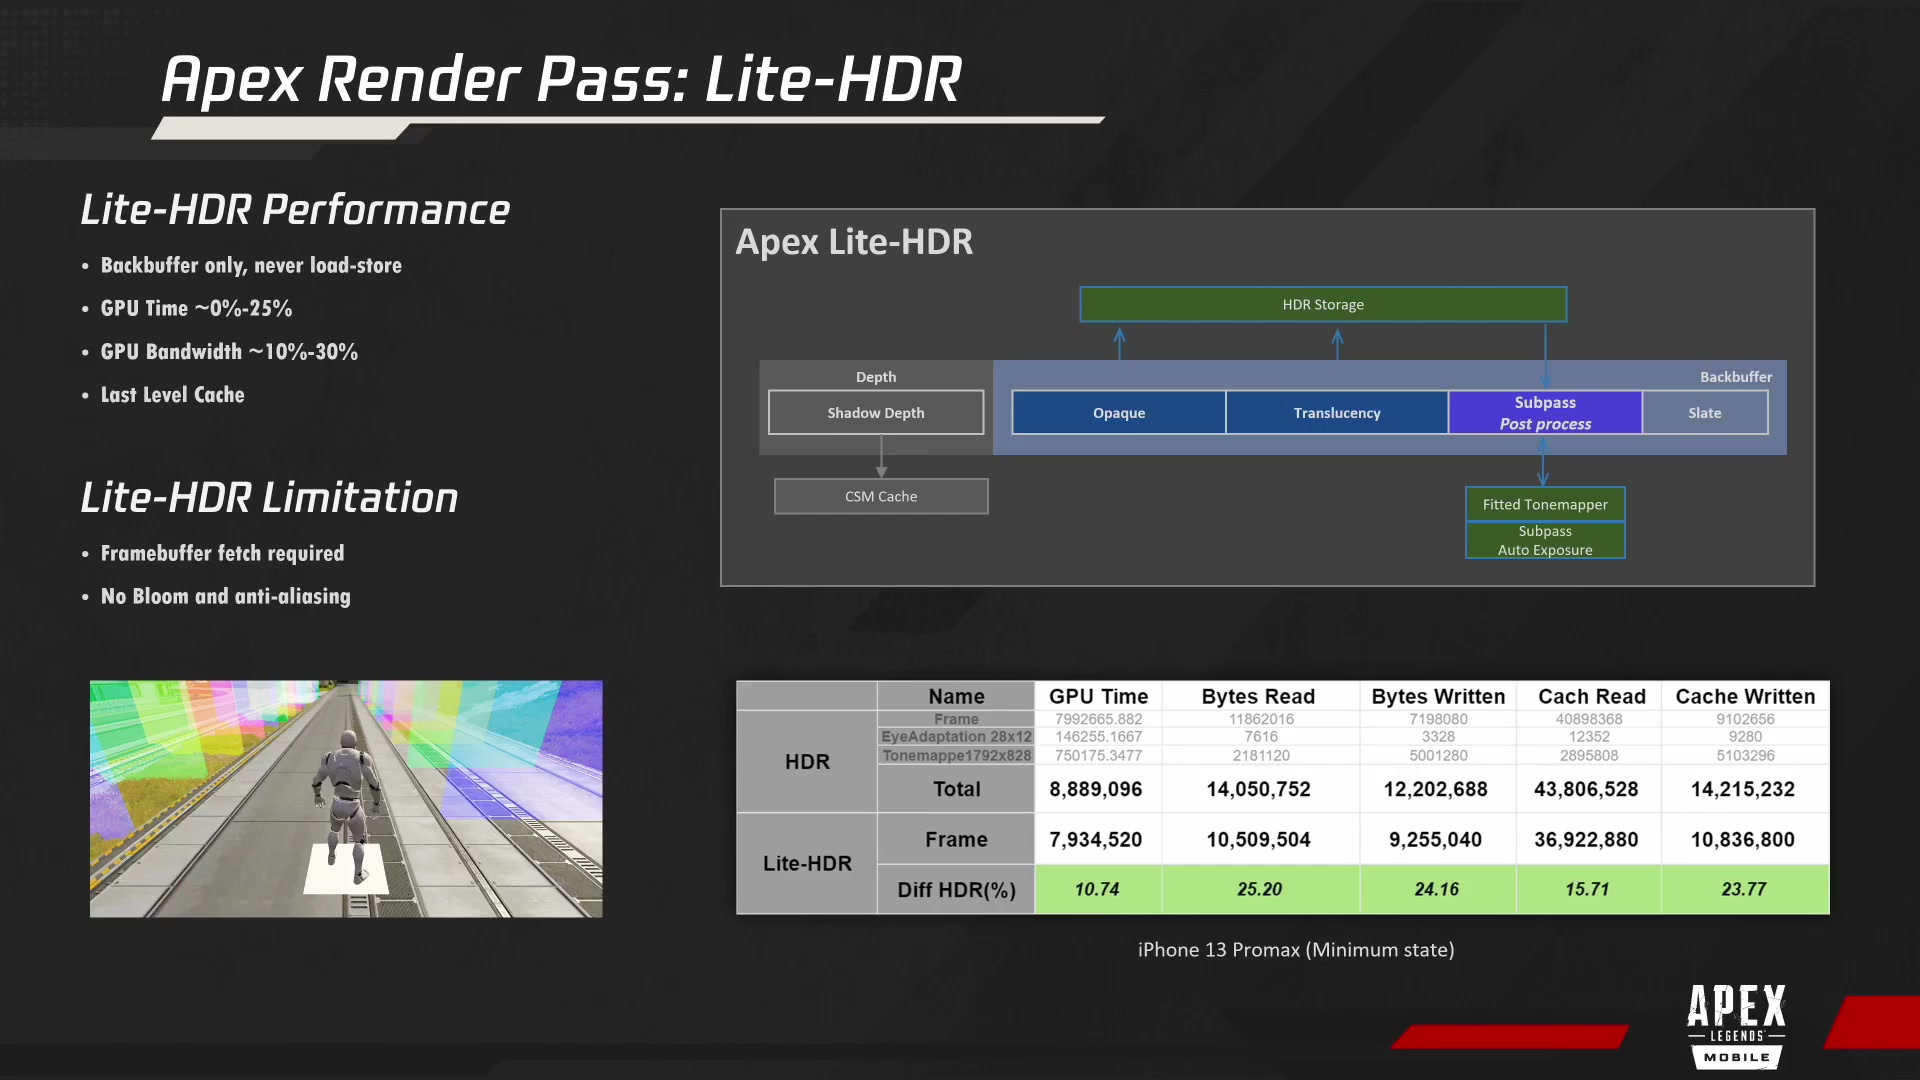
原片 31:46。对照是同页的 HDR 与 Lite-HDR;表里的 GPU Time、读写字节和缓存计数各自有基线。
低频半透明按需离屏
烟雾、毒气等低频透明物重叠时,将它们画到低分辨率 Render Target,再合成回主画面,降低像素着色量。开启离屏本身会增加 Pass 和合成成本。项目由美术提供 Overdraw 系数,CPU 用包围盒估算屏占比,再据此按需开启离屏路径。
原视频索引
原片 ApexM 渲染优化实战.mp4,约 34 分 39 秒。时间为视频内位置。
| 时间 | 内容 |
|---|---|
01:27–04:52 | 场景还原、高帧率、设备兼容性与功耗压力 |
05:13–10:05 | Lightmap、Probe、ILC、阴影分档、子关卡与植被 |
10:05–14:16 | HISM 缓冲合并、LRU、Uniform 动态实例合批 |
14:17–22:40 | 常规剔除、簇树结构、运行时测试和分场景数据 |
23:45–29:35 | UE4 HDR/LDR 基线、拟合 Tonemapper、自动曝光 |
29:35–34:34 | Lite-HDR Subpass、设备条件、带宽数据、低频半透明 |
相关
- 三角洲行动端手一体地形渲染方案:同样受移动端带宽约束,地形方案展示了虚拟纹理页生成如何利用 Framebuffer Fetch。