《三角洲行动》的多人地图在 PC、主机和手机上混用 Lightmap 与预计算 Volume GI。PC 用贴近静态表面的稀疏高精度体素解决近处细节和大部分漏光,再以小型神经网络覆盖全视距。手机由 CPU 异步组装相机周围的规则 3D 纹理,让 GPU 直接采样,并用建筑内部体积处理穿墙插值。单人战役《黑鹰坠落》使用 UE5 Lumen,缩短光照迭代时间。
背景
资料来自 Unreal Fest Shanghai 2025,腾讯天美 J3 工作室引擎技术组蔚东辰的《〈三角洲行动〉中的全局光照方案》。项目要求多人地图端手同步发布,玩家可见区域有 GI 覆盖。PC 和主机希望增加精度与可见距离,同时压住显存和制作时间。手游优先看包体、GPU 耗时和功耗,所以同一地图会用不同的运行时表示。多人先满足广泛机型和高帧率,再考虑如何缩短制作周期。
Lightmap、Volume GI 与 Lumen 的分工
| 方案 | 运行时与制作取舍 | 项目中的用法 |
|---|---|---|
| Lightmap | 用光照 UV 直接取预计算结果,运行成本低且局部可给高精度。需要制作第二套 UV、分配 Texel 密度并反复烘焙,铺满大地图的制作成本很高 | 多人地图局部使用,尤其是需要高精度的室内。所述 Lightmap 保存人工光和天光可见度,由 Volume GI 提供太阳光间接反弹。这样局部美术烘焙可以独立于全图太阳方向调整 |
| 预计算 Volume GI | 世界坐标决定采样位置,光照数据与 Mesh UV 解耦,可自动分块滚动烘焙。需要控制空间查询、内存和漏光 | 多人地图的广覆盖方案。PC 用稀疏结构和全视距补充,手机缩小体积覆盖并扩大 Lightmap 使用范围 |
| Lumen | 动态计算增大 GPU 开销,光照调整可立即看到 | 单人战役《黑鹰坠落》,开发时间紧、需要频繁美术迭代 |
项目使用从《穿越火线手游》时期持续迭代的自研 Lightmap Baker,分享时已是 GPU 烘焙器。团队将烘焙速度、运行成本和美术返工一起纳入选择。Volume GI 如果频繁穿墙漏光,后期逐处加补丁或增加昂贵运行时处理,都可能抵消省下的制作时间。
PC 近处 Volume GI 先定防漏光规则
三线性插值可能把墙两侧的体素混在一起。PC 方案先将近静态表面的体素精度定到 0.25 m,并把墙厚超过 0.25 m 作为项目制作规范,让常规墙体的插值邻域尽量落在同一侧。必须更薄的铁皮等对象按例外处理。这个规则要在资产大量制作前定下来,才能减少后期调试与返工。
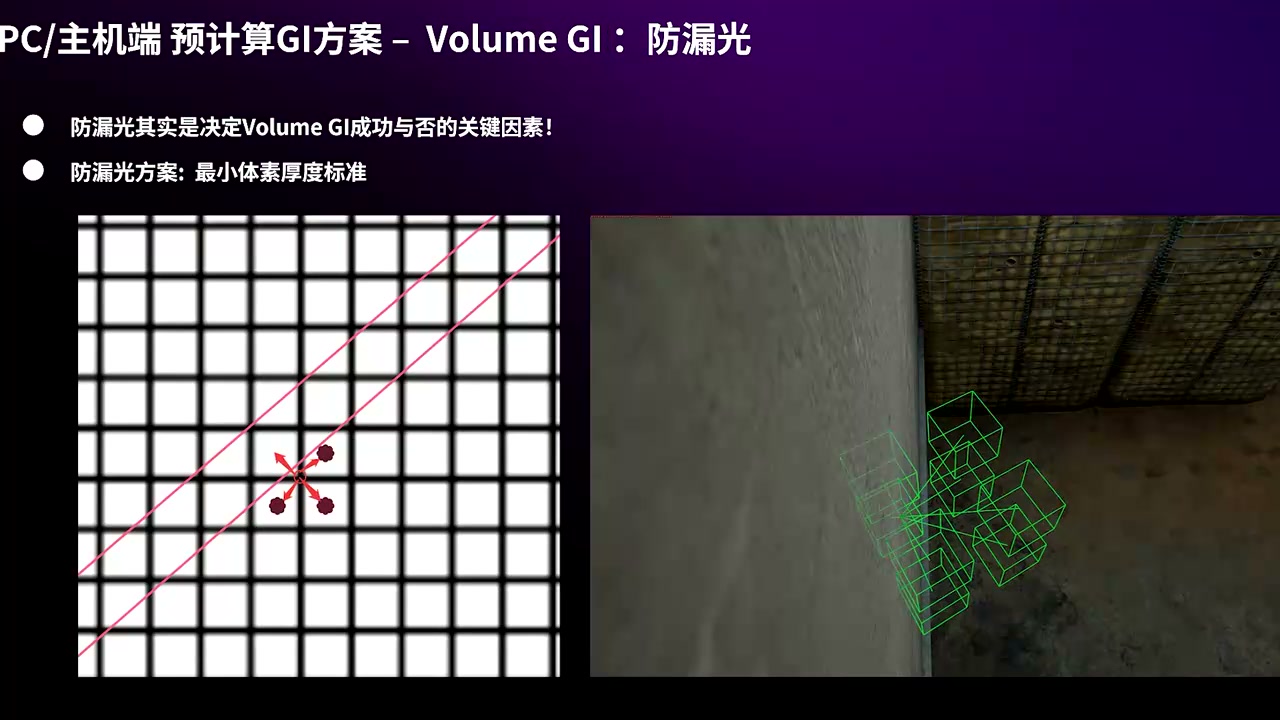
原片 10:14。左图画出跨墙插值的风险,右图显示沿墙加密的体素。
基础元素是 Ambient Cube,存六个轴向上的 Irradiance,幻灯片给出的原始开销为 48 B。运行时按世界坐标查找光照,并按表面法线从六方向重建结果。若直接给整个地图铺匀密的 0.25 m 网格,显存难以承受。项目参考 UE4 OpenVDB,用稀疏树把高分辨率限制在 Mesh 附近。
- 分块与分裂。 离线按横向
64 × 64 m划 Tile。每 Tile 先存4 × 4 × 4 m粗体素。每个4 m节点沿三轴各分四份,产生 64 个1 m候选子节点,示例保留距 Mesh 约3 m内的节点。再将1 m节点分成至多 64 个0.25 m节点,只保留距表面约0.3 m内的部分。 - 紧凑存储。 用 BFS 把树节点线性化,同一父节点保留的子节点连续。父节点存 64 位存在掩码以及第一个子节点的下标。局部坐标映射到候选位,先判断是否存在,再用掩码前缀的
countbits求有效子节点的序号。前缀中为 1 的位数加首子节点偏移,就是实际下标。 - Shader 查询。 用世界坐标定位 Tile 与局部节点,按上述方式逐层定位。光照数据按相同顺序存放,得到下标即可读取。完整的三线性重建需要查八个采样点,位操作用来降低每次查树的成本。
Ambient Cube 按法线求值
设 为单位法线。对每个轴按符号选出对应的轴向颜色 ,再以平方分量加权。
例如法线 ,就各取一半 与 方向的系数。平方权重之和为 1;空间上的三线性插值另用世界坐标计算,这两组权重分别处理方向和位置。
稀疏子节点如何从 64 位掩码定位
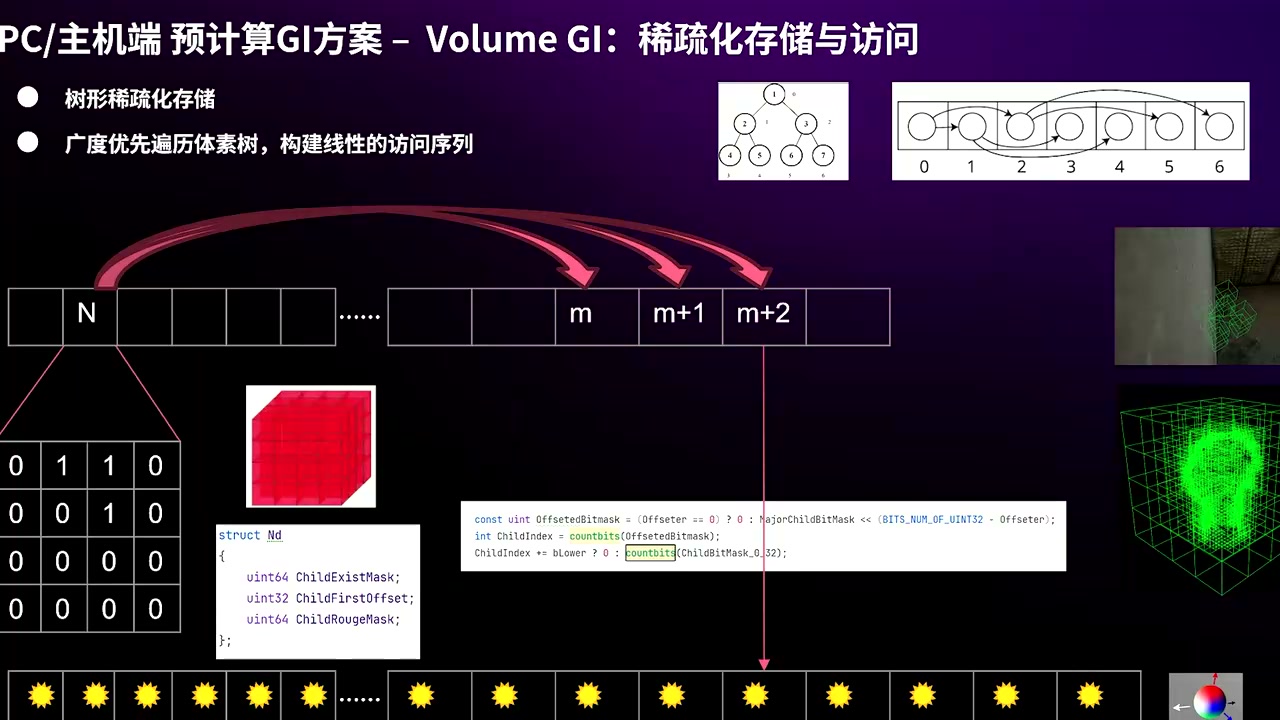
原片 12:54。父节点指向紧凑数组中第一个子节点。右下代码用 countbits 计算要跳过几个已存在的子节点。
令 为存在掩码, 是候选槽, 是首子节点偏移。仅当 的第 位为 1 时访问数据。
例如掩码只打开槽 0、2、5,且 b=120,查槽 5 时它前面有两个已存节点,返回 122,查槽 4 则为空。下面的 HLSL 拆成两个 32 位字,并约定 mask.x 存低 32 位。
bool TryChildIndex(uint2 mask, uint first, uint slot, out uint index)
{
    index = 0;
    if (slot >= 64u)
        return false;

    uint bit = slot & 31u;
    uint word = (slot < 32u) ? mask.x : mask.y;
    uint flag = 1u << bit;
    if ((word & flag) == 0u)
        return false;

    uint rank = countbits(word & (flag - 1u));
    if (slot >= 32u)
        rank += countbits(mask.x);

    index = first + rank;
    return true;
}
用稀疏 Probe 压缩密集体素和多时段数据
高密度网格即使稀疏化后,逐体素保留 48 B Ambient Cube 并为每个 TOD 时段复制一份,仍会增加存储和 GPU 上传压力。团队用 OpenVDB 生成场景 SDF,在接近 Mesh 表面的等值区域布一批密度更低的 Probe,给 Probe 烘焙各时段的 Ambient Cube。密集体素则用最近四个 Probe 的线性组合近似原始光照。
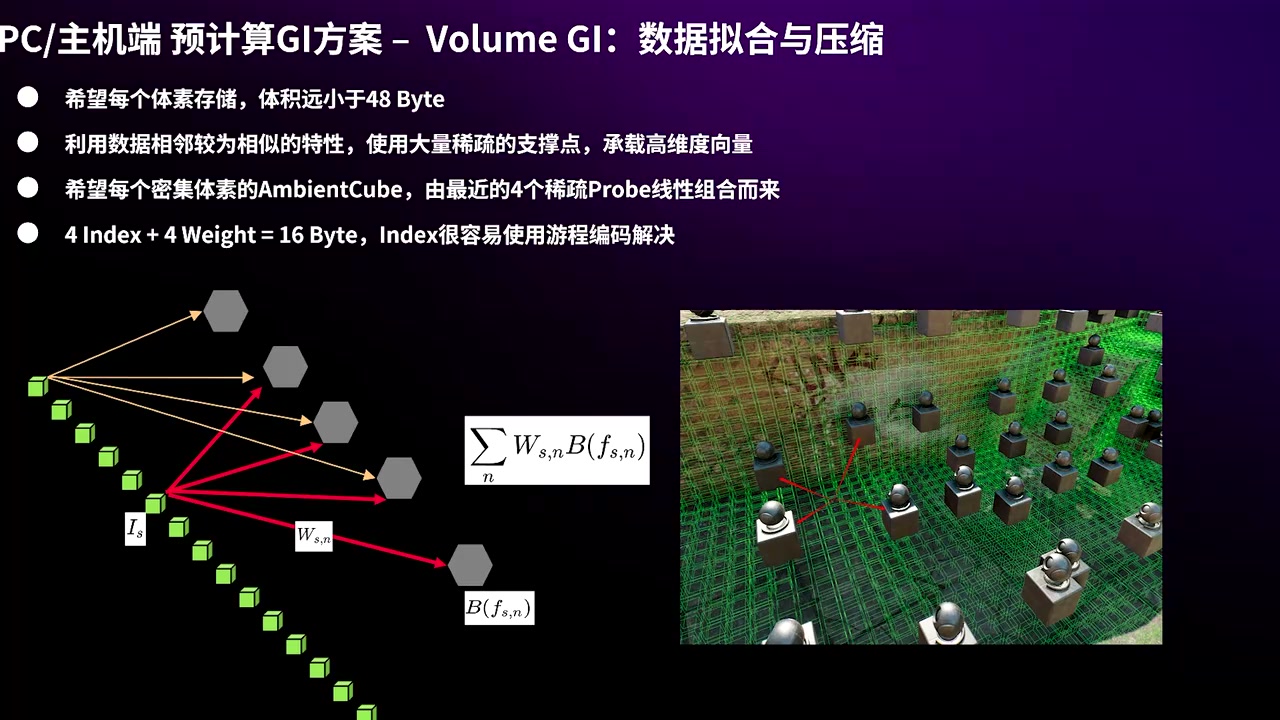
原片 15:46。体素记录轻量的连接关系与权重,Probe 承载随时段变化的高维光照。
- 存储。 密集体素存四个 Probe 索引和四个权重,幻灯片标注压缩记录为
16 B,体素侧无需按 TOD 时段复制几套完整光照。多个时段的数据集中保存在稀疏 Probe 上。相邻体素常复用索引组合,项目还使用游程编码压缩索引。 - 拟合。 将权重和 Probe 值都作为优化变量,最小化体素烘焙值与重建值之间的平方误差,并加权重 L2 正则。C++ 优化器使用共轭梯度法、面向数据的布局和 SIMD,生产中把拟合放在烘焙后的并行流水线上。
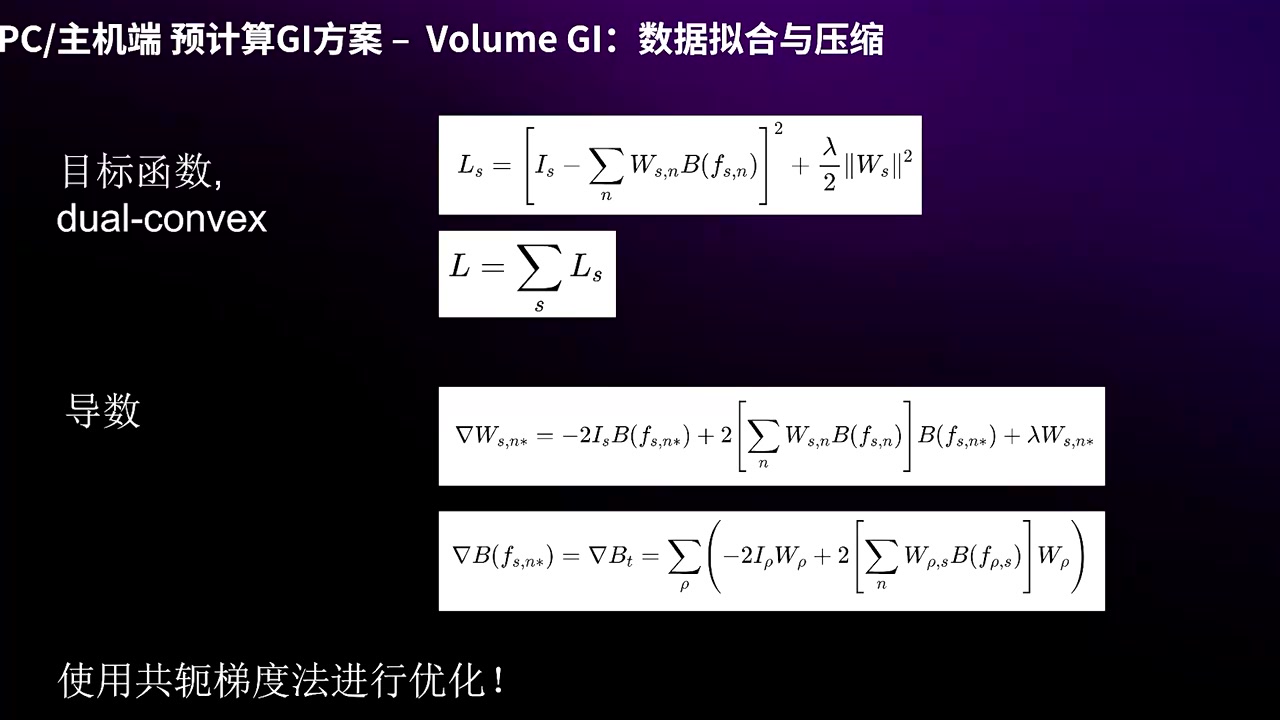
原片 16:52。报告对所有体素样本求和,并对权重加 L2 正则。
把样本下标记为 , 是第 个支持 Probe 的全局下标。按报告的目标,重建与损失分别为
16 B 比 48 B 少三分之二,这只比较密集体素记录本身。Tile 索引、Probe 的多时段数据、流送缓存和上传用缓冲仍会占空间。
讲者给出的量级是刀锋地图 Volume GI 显存约 200 MB,用于理解该地图的近处高精度流送预算。
PC 全视距 GI 用小网络拟合体素内部变化
近处 Tile 的高精度流送范围无法覆盖远处整张地图。团队为远处增加全图常驻的粗稀疏体素,实装边长为 8 m。每个大体素存一个常量会抹掉屋檐和建筑附近的亮暗变化,所以用一个小网络近似体素内部的空间函数。
- 训练与存储。 对每个大体素离线密集烘焙样本,以局部
x、y、z为输入,拟合光照标量。示意网络为3 → 4 → 4 → 1,有两层宽度为 4 的隐藏层,激活使用 Leaky ReLU。幻灯片给出的单网络开销为88 B。项目用自实现优化器训练,运行时以少量矩阵运算和激活恢复体素内部变化。 - 分辨率边界。 标量拟合可保存远处主要明暗层次,示例展示了向上的天光可见度。用它贴近观察室内仍能看见漏光,近距离遮挡细节交给高精度流送的体素。这是用来给远处建立连续覆盖的表示。
- 显存与 GPU 样本。 全视距数据示例约为风暴眼
22 MB、刀锋11 MB、监狱8 MB,讲者说明这是未压缩资源量,对应其显存占用。攀升地图的 RTX 3080 示例里,讲者给出全部 Volume GI(含远景)约0.35 ms,同次展示的深度 Prepass 约0.32 ms,Base Pass 约0.85 ms。这是该地图和设备的样本。
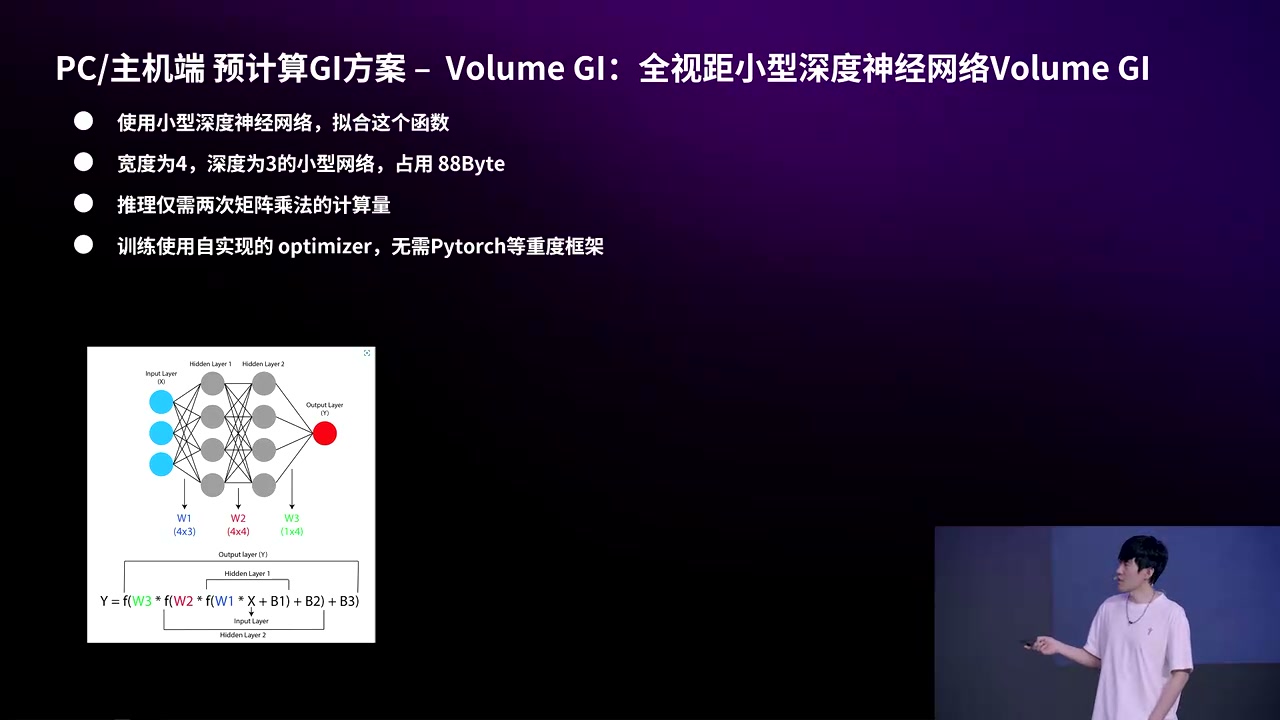
原片 20:32。两个隐藏层都只有四个通道,每个体素拟合一个随位置变化的标量。
图中的前向求值可写成
其中 是体素局部坐标, 为示意图中的 Leaky ReLU。两层隐藏层把位置空间切成多块分段线性区域,可在同一粗体素内给开阔天空和屋檐底下不同的输出。报告给出参数占用 88 B,公式描述网络形状和计算顺序。
Mobile 把空间查询和防漏光放到 CPU 更新阶段
手游 Volume GI 在相机周围提供米级采样,分享给出的近处覆盖尺度约 64 m。GPU 瓶颈下,项目让 CPU 异步组装规则的 M × N × N 3D Scrolling Texture。Shader 运行时从 3D 纹理取 Irradiance,无需像 PC 一样逐像素查树。超出覆盖范围的太阳光 Bounce,中低档使用平均值,高档可用俯拍 2D 纹理。手游比 PC 使用更多 Lightmap 来补足覆盖,Lightmap 同样保存人工光与天光可见度,避免它随时段数量增长。
- 离线分块、块内连续。 按区域分块,块内使用连续存放的局部规则长方体。这样能省下未覆盖空间的包体,又能让 CPU 批量对齐并填充到相机所在的规则纹理,减少逐节点遍历和 Cache Miss。
- 异步和增量上传。 相机移动时滚动更新纹理,由 CPU 小核异步处理,可用 FP16 SIMD 和 UE 的 NEON 封装加速。GPU 上传按层分帧,减少单帧突发开销。
- Interior Volume(IV)防漏光。 米级网格不能依靠普通墙的厚度挡住采样。美术给建筑制作一个或多个凸多面体 IV,让其面落在对应墙内。离线标记可能从墙另一侧漏入的体素并把它们关联到 IV 面。运行时 CPU 按相机处于面的哪一侧,让对侧体素的贡献逐步淡出。分帧上传意味着跨墙后光照可能滞后更新,分享认为在多人对战中这个取舍可接受。
- 更稀疏的 Probe。 使用与 PC 类似的数据拟合和压缩,但降低 Probe 密度。远离 Mesh、没有局部数据块的位置,用最近 Probe 的光照。运行时生成 Distance Vector Field,为这些位置指向最近的 Probe。
滚动纹理与相机过墙
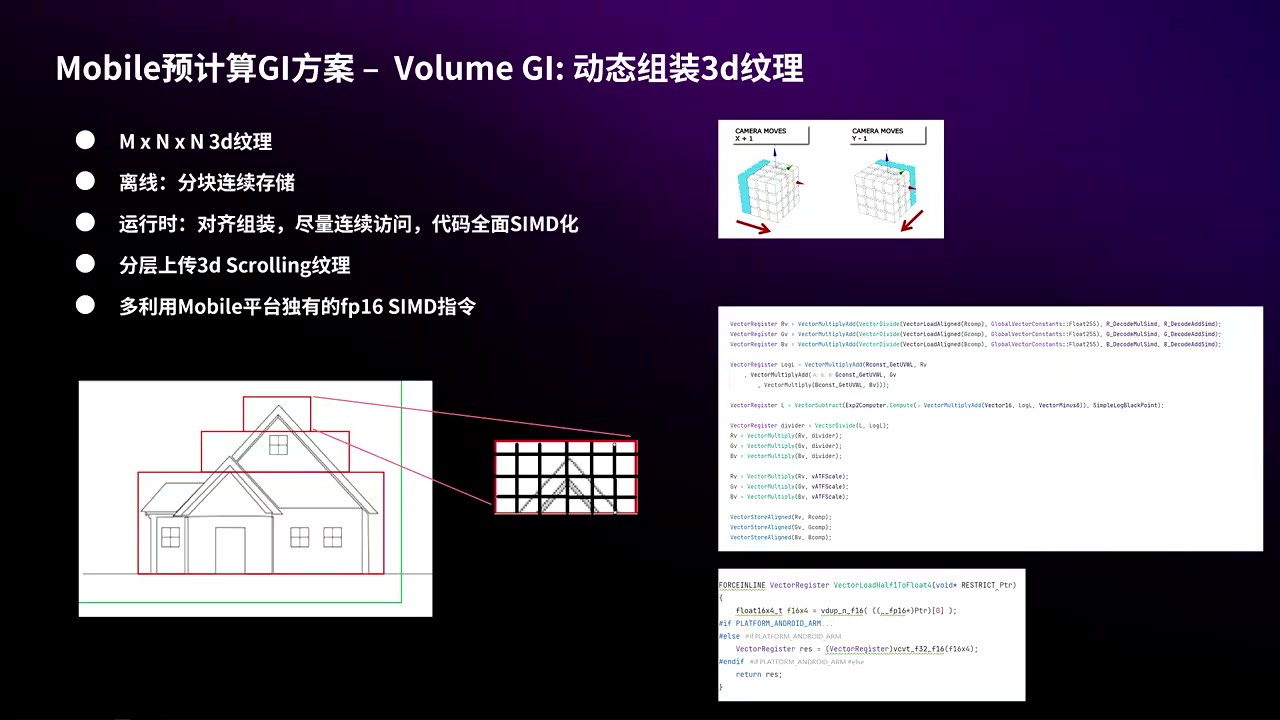
原片 25:58。左下将建筑周围数据拆成连续长方体。右上示意相机跨格后补入的纹理层。
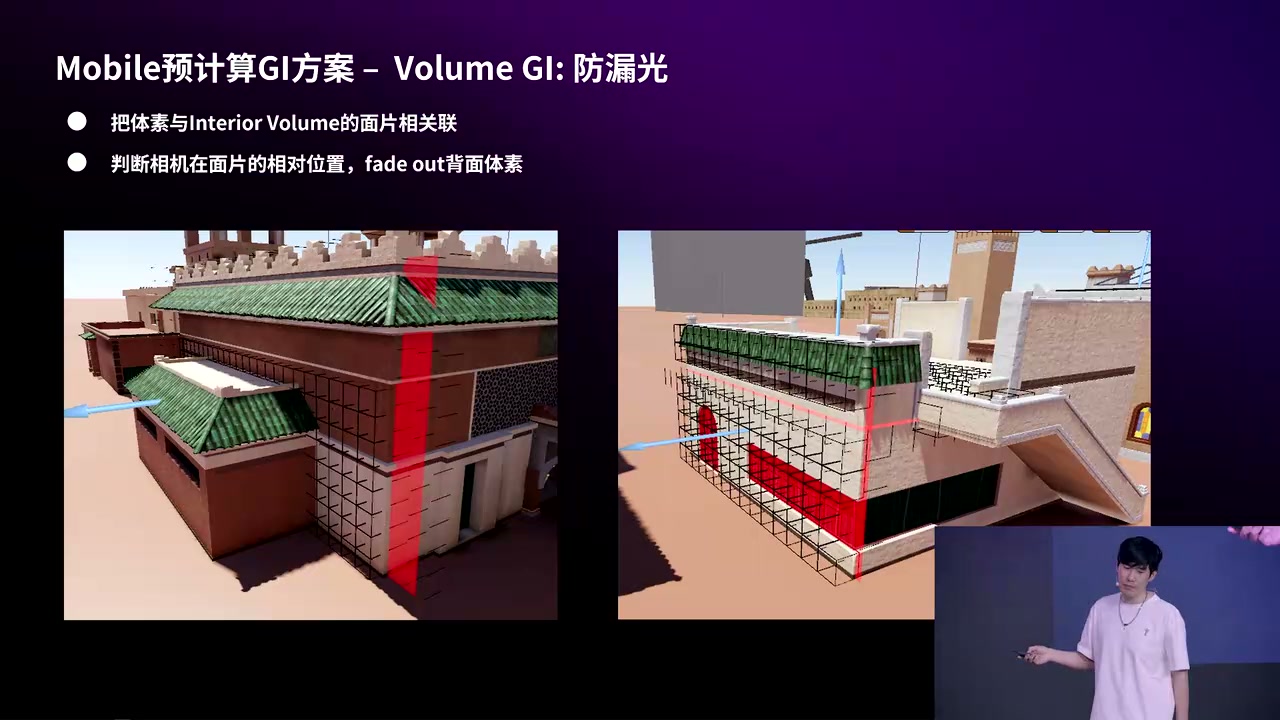
原片 27:04。用建筑简化体积的面给相机和体素判侧,更新时淡出会从墙后串进来的体素。
下列伪代码展示系统要重新组装两类区域。即使相机还在同一纹理格子,只要越过某个 IV 面,已有体素的防漏光系数也可能要更新。具体的淡出曲线和帧预算由实现决定。
dirty = NewCellsAfterScroll(previousWindow, currentWindow)
dirty += CellsAffectedByCrossedInteriorPlanes(previousCamera, camera)

for cell in dirty:
    light = DecodeTileSampleOrNearestProbe(cell)
    for plane in InteriorPlanesLinkedTo(cell):
        if Side(plane, camera) * Side(plane, cell.center) < 0:
            light *= BackSideFade(plane, camera, cell)
    QueueLayerUpdate(PhysicalTextureAddress(cell), light)

UploadQueuedLayersWithinBudget()
28:36 的 Volume GI 包量示例为刀锋 29 MB、监狱 83 MB、航天基地 84 MB、巴克什 99 MB、风暴眼 104 MB、大坝 140 MB、长弓溪谷 334 MB。讲者估算长弓溪谷如果全部改用 Lightmap,GI 数据会超过现有 Volume GI 的五倍。表中是移动端 Volume GI 包量,PC 段落给出的是显存口径。
单人战役采用原生 UE5 Lumen
《黑鹰坠落》用原生 UE5 Lumen 做动态 GI。制作时可以调整后立即看结果,减少按场景反复烘焙的等待。分享展示的是 Software Ray Tracing 路径,使用 Mesh SDF 与 Voxel。讲者在项目测试中观察到,约 RTX 3080 级别以上硬件的 Hardware Ray Tracing 路径才开始在性能上超过所测软件路径,团队据此选择软件追踪以覆盖其目标配置。
原视频索引
原片 三角洲 GI 方案.mp4,约 31 分 06 秒。时间为视频内位置。
| 时间 | 内容 |
|---|---|
01:15–07:42 | 双端目标、GI 选型、Lightmap 的用途与制作成本 |
07:42–14:50 | 防漏光规则、Ambient Cube、稀疏树与位掩码访问 |
14:50–18:16 | Probe 拟合、TOD 压缩、近处方案显存 |
18:17–24:01 | 全视距神经网络 GI、显存占用与 GPU 样本 |
24:01–29:35 | Mobile Lightmap、3D Scrolling Texture、IV 防漏光与包量 |
29:35–31:05 | 《黑鹰坠落》Lumen 和选型总结 |
相关
- 三角洲行动端手一体地形渲染方案:地形 Clipmap 和手游 3D 滚动纹理都用移动窗口控制相机附近的数据驻留。